Floppydata Floppydata
Início Web scraping

API de web scraping

Chega de bloqueios, CAPTCHAs e requisições com falha no scraping. Colete dados de qualquer site sem complicações. Taxa de sucesso de 99,9%.

  • Lide automaticamente com bloqueios, CAPTCHAs e sistemas antibot
  • Extraia dados completos da web — HTML, JSON ou TXT — com um clique
  • Integração simples via API, com taxa de sucesso de 99,9% e suporte 24/7
Alvos populares

Qualquer URL pública funciona — estes são apenas exemplos predefinidos.
curl https://api.floppydata.net/v2/web-data/fetch \
--request POST \
--header 'Content-Type: application/json' \
--header 'X-Api-Key: YOUR_API_KEY' \
--data '{
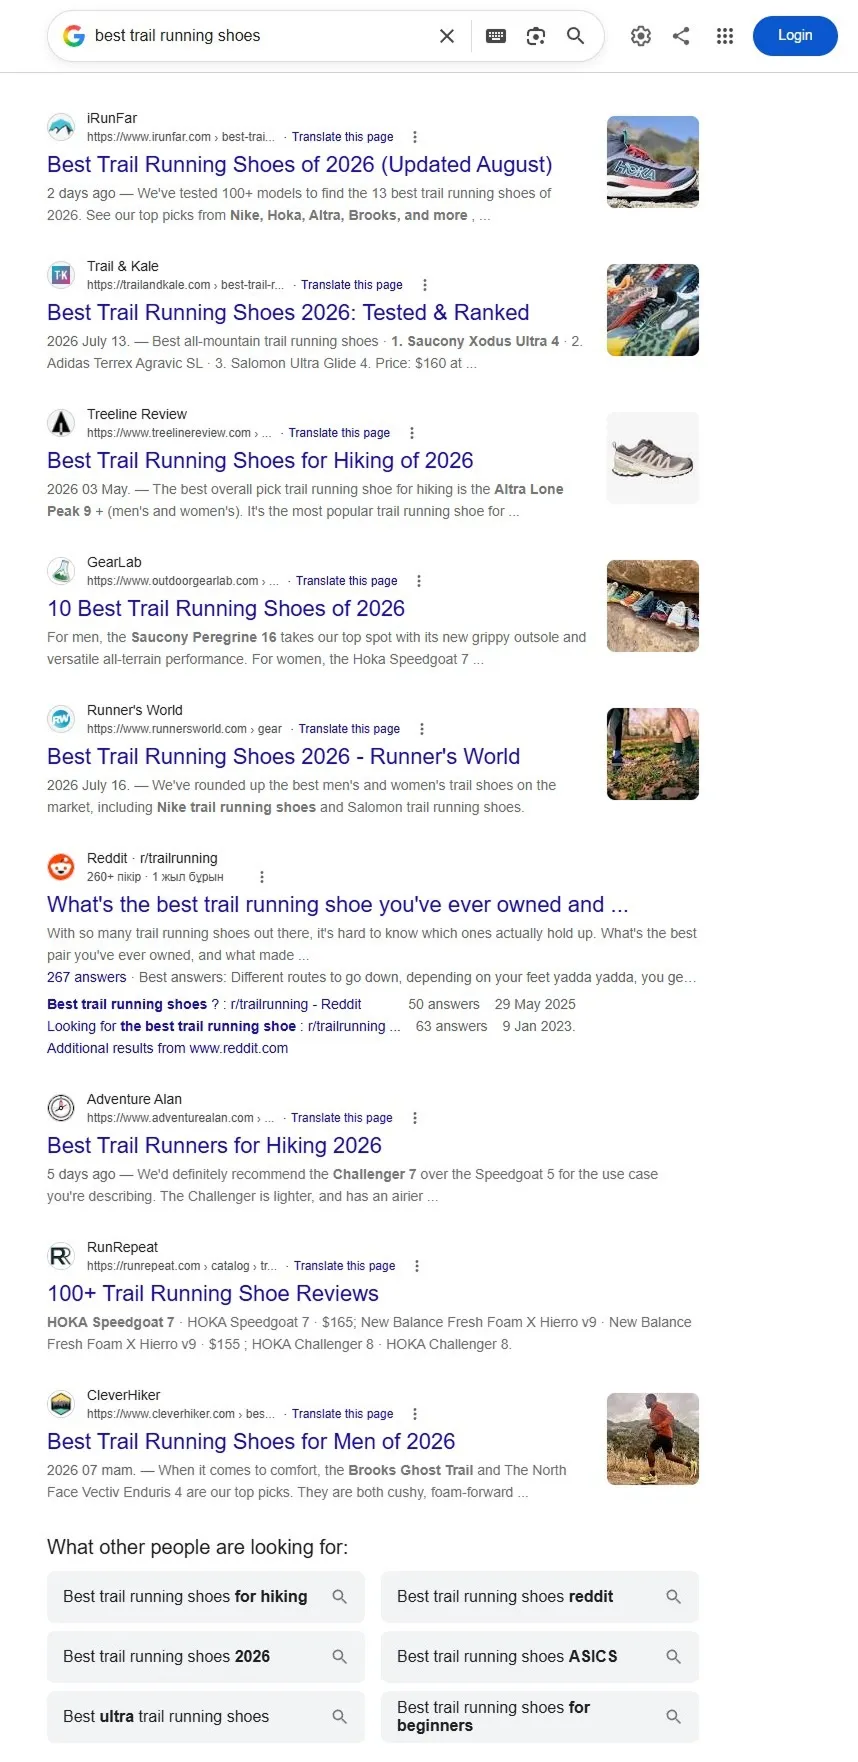
"url": "https://www.google.com/search?q=best+trail+running+shoes",
"countryCode": "US",
"city": "New York",
"difficulty": "auto"
}'
import httpx
response = httpx.post(
"https://api.floppydata.net/v2/web-data/fetch",
headers={
"Content-Type": "application/json",
"X-Api-Key": "YOUR_API_KEY",
},
json={
"url": "https://www.google.com/search?q=best+trail+running+shoes",
"countryCode": "US",
"city": "New York",
"difficulty": "auto",
},
)
data = response.json()
print(data["html"])
const response = await fetch('https://api.floppydata.net/v2/web-data/fetch', {
method: 'POST',
headers: {
'Content-Type': 'application/json',
'X-Api-Key': 'YOUR_API_KEY',
},
body: JSON.stringify({
url: 'https://www.google.com/search?q=best+trail+running+shoes',
countryCode: 'US',
city: 'New York',
difficulty: 'auto',
}),
});
const { html } = await response.json();
console.log(html);
<?php
$ch = curl_init('https://api.floppydata.net/v2/web-data/fetch');
curl_setopt($ch, CURLOPT_POST, true);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
curl_setopt($ch, CURLOPT_HTTPHEADER, [
'Content-Type: application/json',
'X-Api-Key: YOUR_API_KEY',
]);
curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode([
'url' => 'https://www.google.com/search?q=best+trail+running+shoes',
'countryCode' => 'US',
'city' => 'New York',
'difficulty' => 'auto',
]));
$response = curl_exec($ch);
curl_close($ch);
echo $response;
package main
import (
"fmt"
"io"
"net/http"
"strings"
)
func main() {
url := "https://api.floppydata.net/v2/web-data/fetch"
payload := strings.NewReader(`{"url":"https://www.google.com/search?q=best+trail+running+shoes","countryCode":"US","city":"New York","difficulty":"auto"}`)
req, _ := http.NewRequest("POST", url, payload)
req.Header.Add("Content-Type", "application/json")
req.Header.Add("X-Api-Key", "YOUR_API_KEY")
res, _ := http.DefaultClient.Do(req)
defer res.Body.Close()
body, _ := io.ReadAll(res.Body)
fmt.Println(string(body))
}
curl https://api.floppydata.net/v2/web-data/fetch \
--request POST \
--header 'Content-Type: application/json' \
--header 'X-Api-Key: YOUR_API_KEY' \
--data '{
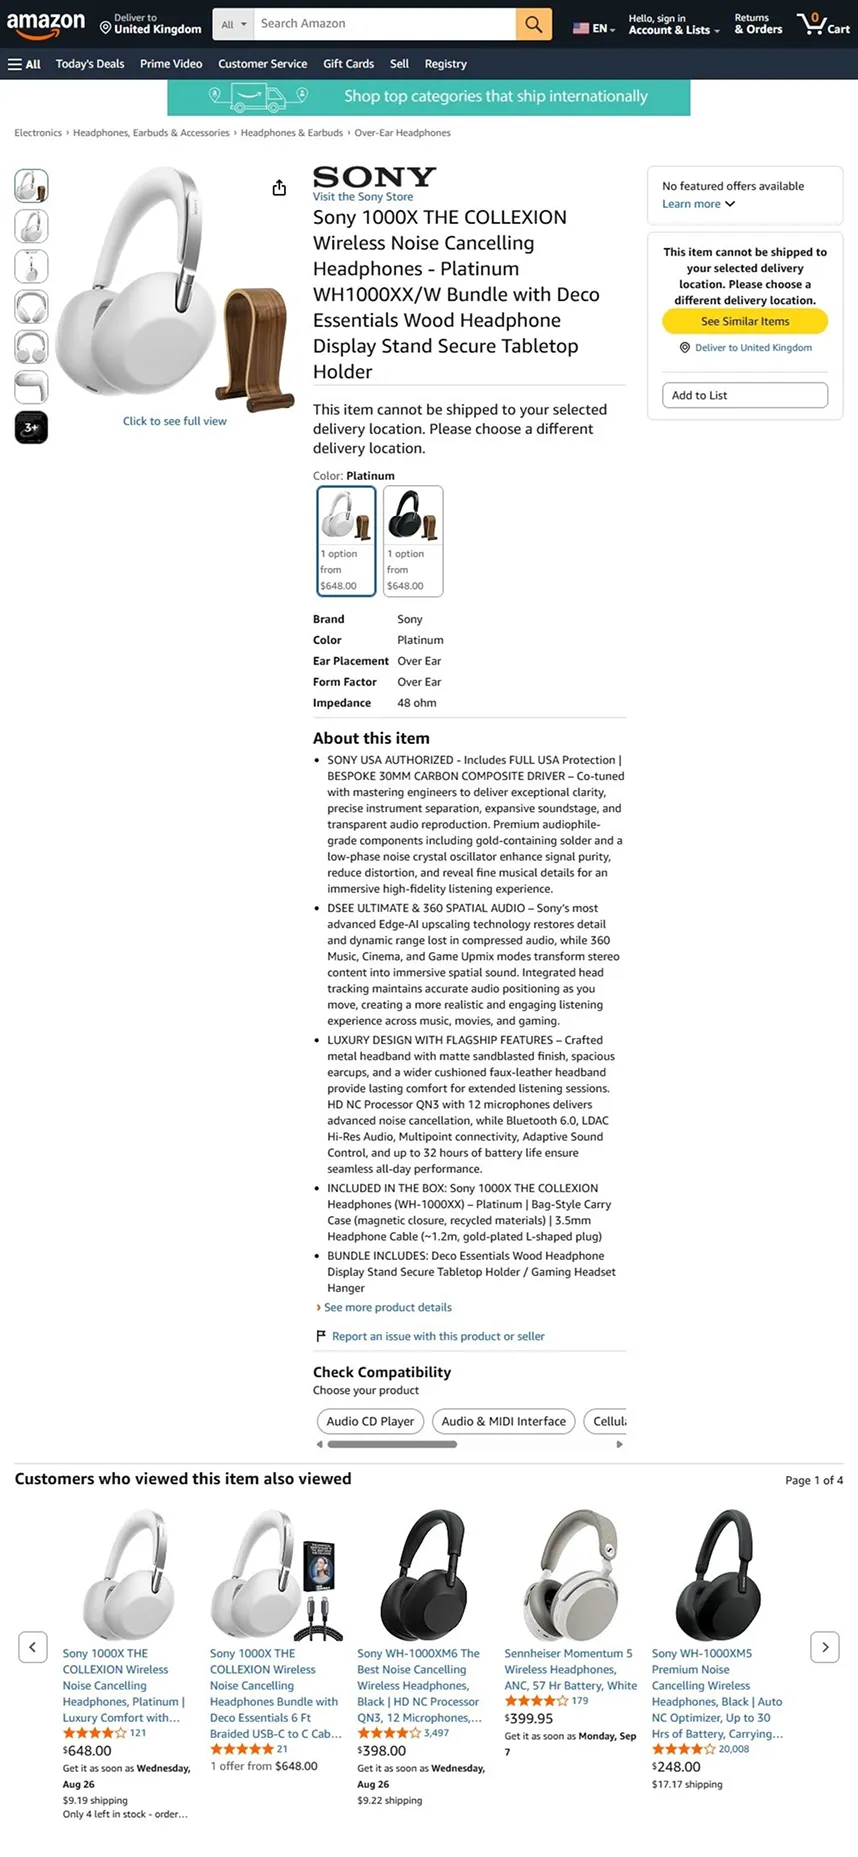
"url": "https://www.amazon.com/dp/B0C1000XWH",
"countryCode": "US",
"city": "New York",
"difficulty": "auto"
}'
import httpx
response = httpx.post(
"https://api.floppydata.net/v2/web-data/fetch",
headers={
"Content-Type": "application/json",
"X-Api-Key": "YOUR_API_KEY",
},
json={
"url": "https://www.amazon.com/dp/B0C1000XWH",
"countryCode": "US",
"city": "New York",
"difficulty": "auto",
},
)
data = response.json()
print(data["html"])
const response = await fetch('https://api.floppydata.net/v2/web-data/fetch', {
method: 'POST',
headers: {
'Content-Type': 'application/json',
'X-Api-Key': 'YOUR_API_KEY',
},
body: JSON.stringify({
url: 'https://www.amazon.com/dp/B0C1000XWH',
countryCode: 'US',
city: 'New York',
difficulty: 'auto',
}),
});
const { html } = await response.json();
console.log(html);
<?php
$ch = curl_init('https://api.floppydata.net/v2/web-data/fetch');
curl_setopt($ch, CURLOPT_POST, true);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
curl_setopt($ch, CURLOPT_HTTPHEADER, [
'Content-Type: application/json',
'X-Api-Key: YOUR_API_KEY',
]);
curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode([
'url' => 'https://www.amazon.com/dp/B0C1000XWH',
'countryCode' => 'US',
'city' => 'New York',
'difficulty' => 'auto',
]));
$response = curl_exec($ch);
curl_close($ch);
echo $response;
package main
import (
"fmt"
"io"
"net/http"
"strings"
)
func main() {
url := "https://api.floppydata.net/v2/web-data/fetch"
payload := strings.NewReader(`{"url":"https://www.amazon.com/dp/B0C1000XWH","countryCode":"US","city":"New York","difficulty":"auto"}`)
req, _ := http.NewRequest("POST", url, payload)
req.Header.Add("Content-Type", "application/json")
req.Header.Add("X-Api-Key", "YOUR_API_KEY")
res, _ := http.DefaultClient.Do(req)
defer res.Body.Close()
body, _ := io.ReadAll(res.Body)
fmt.Println(string(body))
}
curl https://api.floppydata.net/v2/web-data/fetch \
--request POST \
--header 'Content-Type: application/json' \
--header 'X-Api-Key: YOUR_API_KEY' \
--data '{
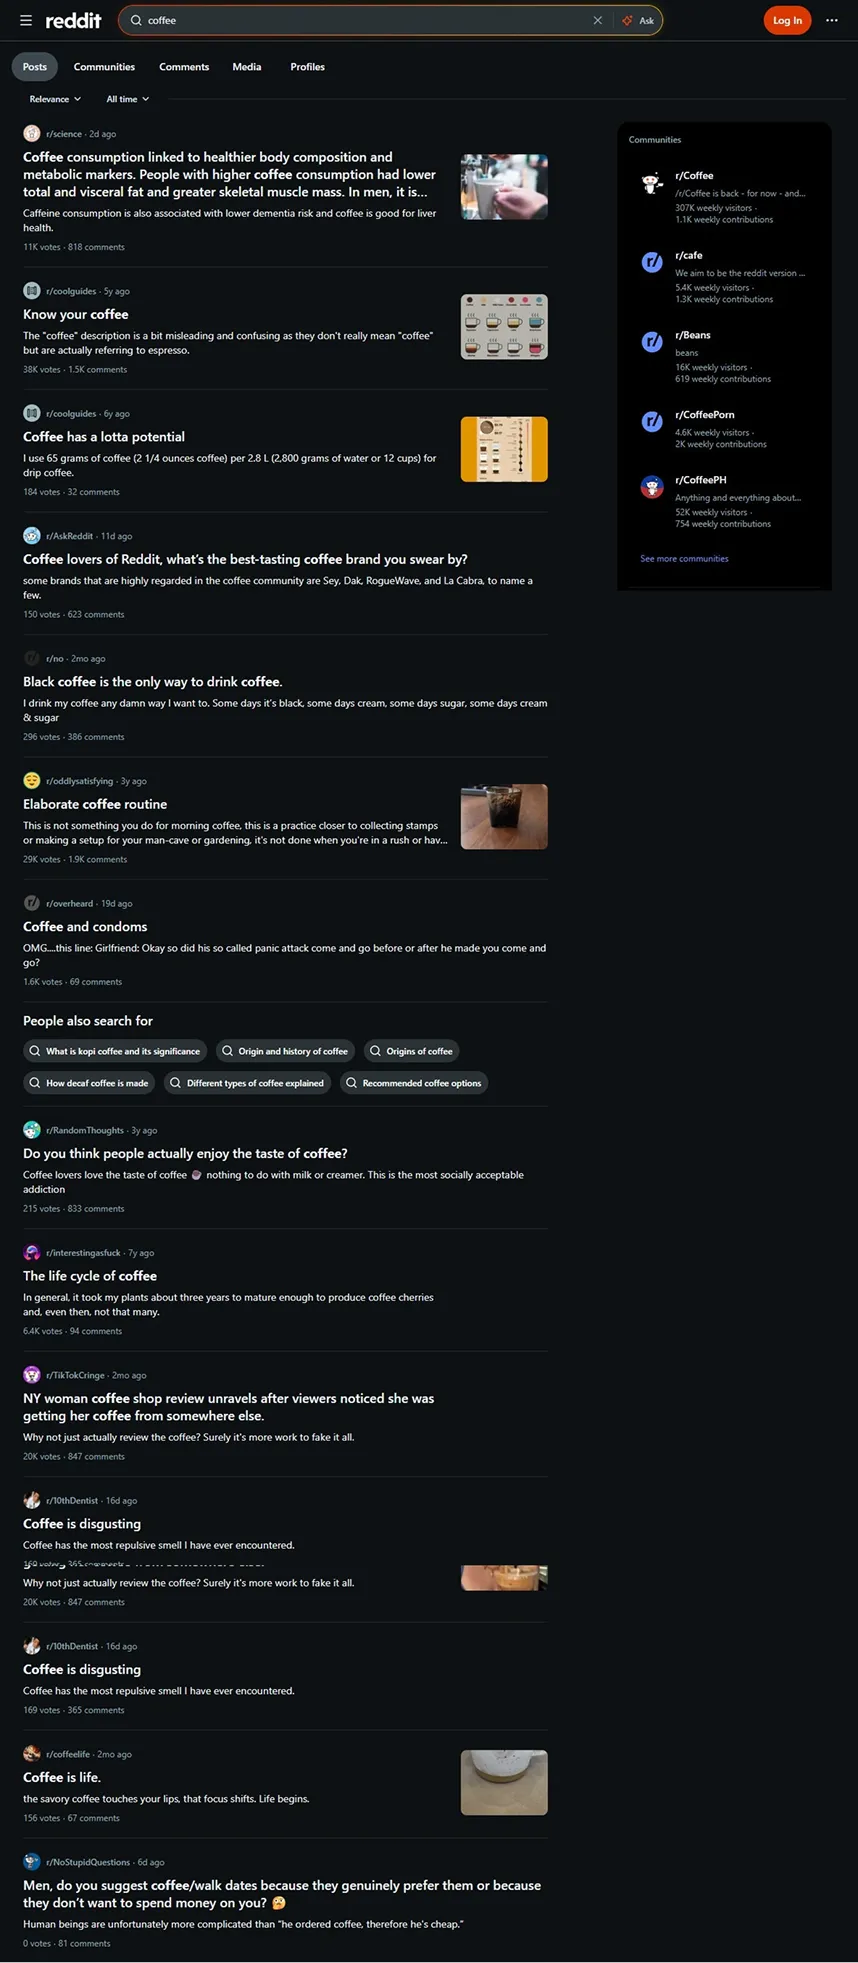
"url": "https://www.reddit.com/search/?q=coffee",
"countryCode": "US",
"city": "New York",
"difficulty": "auto"
}'
import httpx
response = httpx.post(
"https://api.floppydata.net/v2/web-data/fetch",
headers={
"Content-Type": "application/json",
"X-Api-Key": "YOUR_API_KEY",
},
json={
"url": "https://www.reddit.com/search/?q=coffee",
"countryCode": "US",
"city": "New York",
"difficulty": "auto",
},
)
data = response.json()
print(data["html"])
const response = await fetch('https://api.floppydata.net/v2/web-data/fetch', {
method: 'POST',
headers: {
'Content-Type': 'application/json',
'X-Api-Key': 'YOUR_API_KEY',
},
body: JSON.stringify({
url: 'https://www.reddit.com/search/?q=coffee',
countryCode: 'US',
city: 'New York',
difficulty: 'auto',
}),
});
const { html } = await response.json();
console.log(html);
<?php
$ch = curl_init('https://api.floppydata.net/v2/web-data/fetch');
curl_setopt($ch, CURLOPT_POST, true);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
curl_setopt($ch, CURLOPT_HTTPHEADER, [
'Content-Type: application/json',
'X-Api-Key: YOUR_API_KEY',
]);
curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode([
'url' => 'https://www.reddit.com/search/?q=coffee',
'countryCode' => 'US',
'city' => 'New York',
'difficulty' => 'auto',
]));
$response = curl_exec($ch);
curl_close($ch);
echo $response;
package main
import (
"fmt"
"io"
"net/http"
"strings"
)
func main() {
url := "https://api.floppydata.net/v2/web-data/fetch"
payload := strings.NewReader(`{"url":"https://www.reddit.com/search/?q=coffee","countryCode":"US","city":"New York","difficulty":"auto"}`)
req, _ := http.NewRequest("POST", url, payload)
req.Header.Add("Content-Type", "application/json")
req.Header.Add("X-Api-Key", "YOUR_API_KEY")
res, _ := http.DefaultClient.Do(req)
defer res.Body.Close()
body, _ := io.ReadAll(res.Body)
fmt.Println(string(body))
}
curl https://api.floppydata.net/v2/web-data/fetch \
--request POST \
--header 'Content-Type: application/json' \
--header 'X-Api-Key: YOUR_API_KEY' \
--data '{
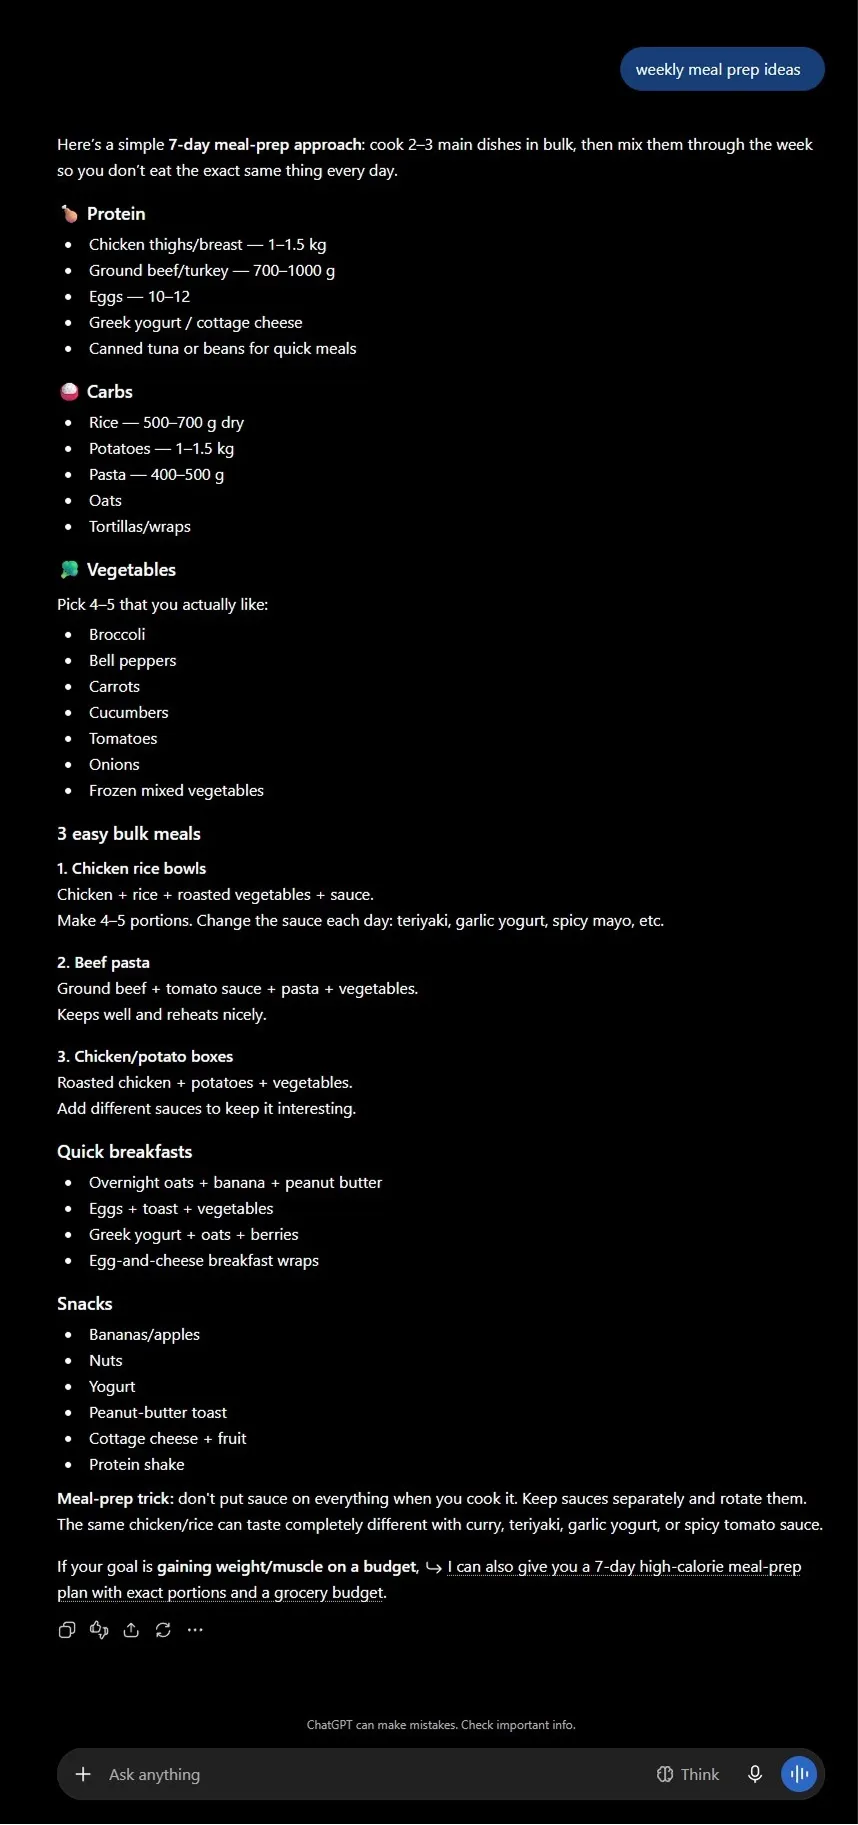
"url": "https://chatgpt.com/?q=weekly+meal+prep+ideas",
"countryCode": "US",
"city": "New York",
"difficulty": "auto"
}'
import httpx
response = httpx.post(
"https://api.floppydata.net/v2/web-data/fetch",
headers={
"Content-Type": "application/json",
"X-Api-Key": "YOUR_API_KEY",
},
json={
"url": "https://chatgpt.com/?q=weekly+meal+prep+ideas",
"countryCode": "US",
"city": "New York",
"difficulty": "auto",
},
)
data = response.json()
print(data["html"])
const response = await fetch('https://api.floppydata.net/v2/web-data/fetch', {
method: 'POST',
headers: {
'Content-Type': 'application/json',
'X-Api-Key': 'YOUR_API_KEY',
},
body: JSON.stringify({
url: 'https://chatgpt.com/?q=weekly+meal+prep+ideas',
countryCode: 'US',
city: 'New York',
difficulty: 'auto',
}),
});
const { html } = await response.json();
console.log(html);
<?php
$ch = curl_init('https://api.floppydata.net/v2/web-data/fetch');
curl_setopt($ch, CURLOPT_POST, true);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
curl_setopt($ch, CURLOPT_HTTPHEADER, [
'Content-Type: application/json',
'X-Api-Key: YOUR_API_KEY',
]);
curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode([
'url' => 'https://chatgpt.com/?q=weekly+meal+prep+ideas',
'countryCode' => 'US',
'city' => 'New York',
'difficulty' => 'auto',
]));
$response = curl_exec($ch);
curl_close($ch);
echo $response;
package main
import (
"fmt"
"io"
"net/http"
"strings"
)
func main() {
url := "https://api.floppydata.net/v2/web-data/fetch"
payload := strings.NewReader(`{"url":"https://chatgpt.com/?q=weekly+meal+prep+ideas","countryCode":"US","city":"New York","difficulty":"auto"}`)
req, _ := http.NewRequest("POST", url, payload)
req.Header.Add("Content-Type", "application/json")
req.Header.Add("X-Api-Key", "YOUR_API_KEY")
res, _ := http.DefaultClient.Do(req)
defer res.Body.Close()
body, _ := io.ReadAll(res.Body)
fmt.Println(string(body))
}
curl https://api.floppydata.net/v2/web-data/fetch \
--request POST \
--header 'Content-Type: application/json' \
--header 'X-Api-Key: YOUR_API_KEY' \
--data '{
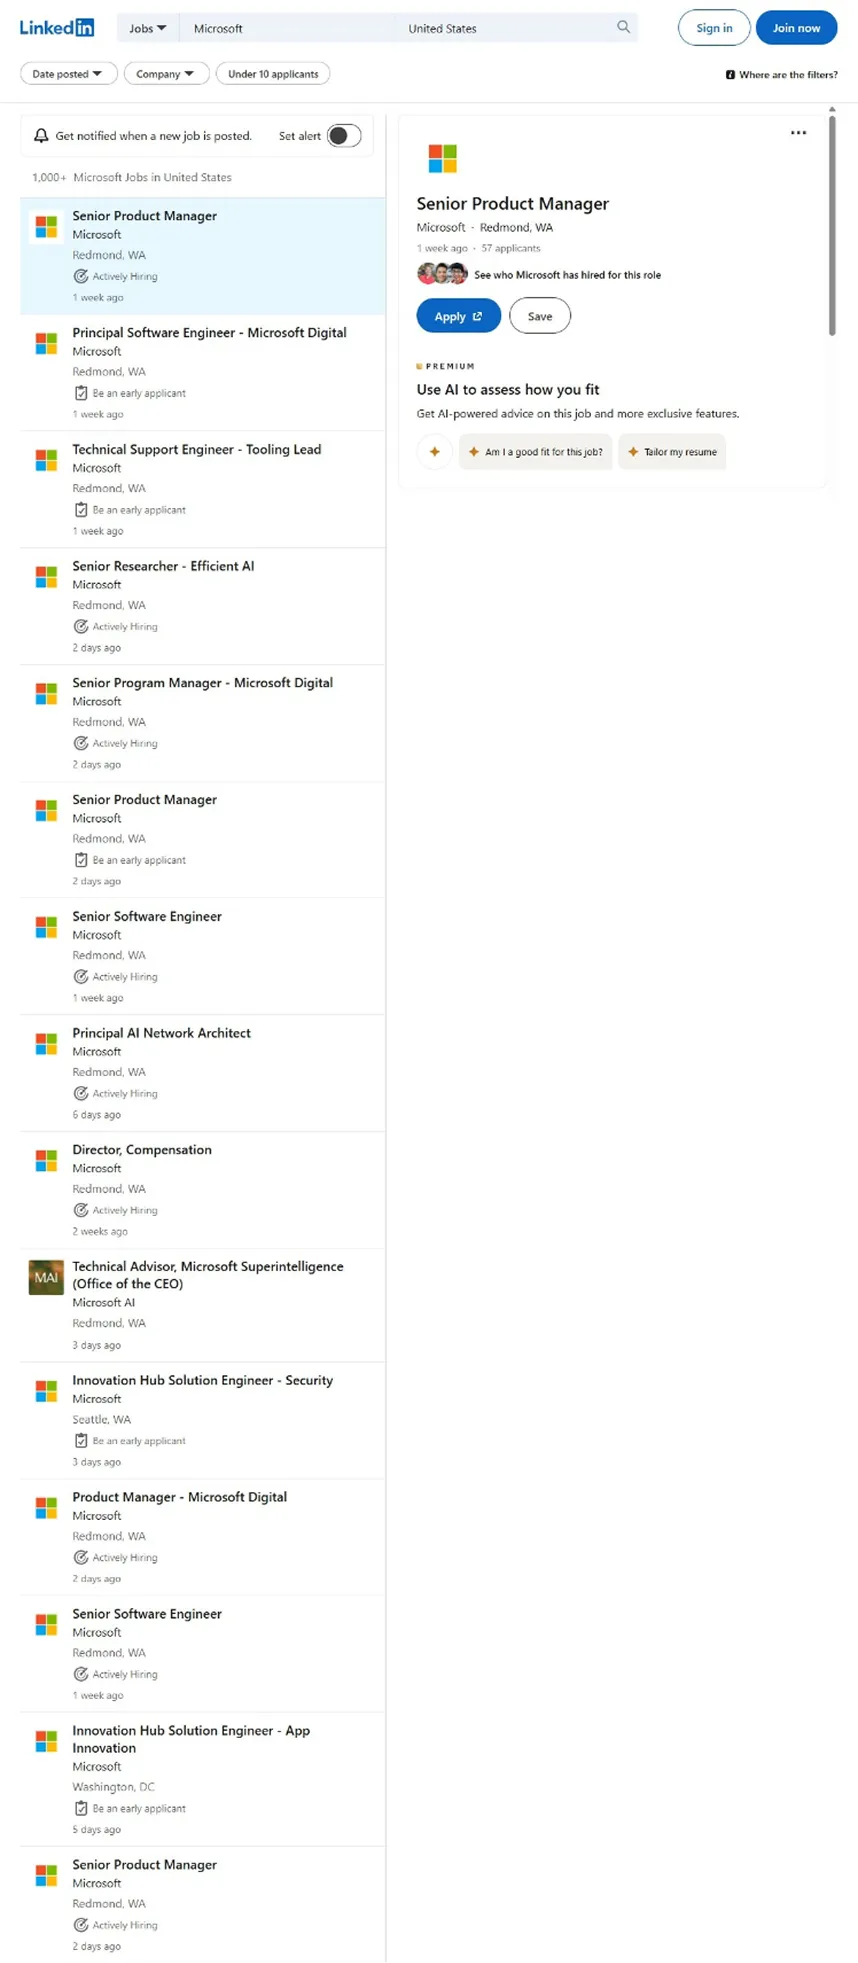
"url": "https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States",
"countryCode": "US",
"city": "New York",
"difficulty": "auto"
}'
import httpx
response = httpx.post(
"https://api.floppydata.net/v2/web-data/fetch",
headers={
"Content-Type": "application/json",
"X-Api-Key": "YOUR_API_KEY",
},
json={
"url": "https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States",
"countryCode": "US",
"city": "New York",
"difficulty": "auto",
},
)
data = response.json()
print(data["html"])
const response = await fetch('https://api.floppydata.net/v2/web-data/fetch', {
method: 'POST',
headers: {
'Content-Type': 'application/json',
'X-Api-Key': 'YOUR_API_KEY',
},
body: JSON.stringify({
url: 'https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States',
countryCode: 'US',
city: 'New York',
difficulty: 'auto',
}),
});
const { html } = await response.json();
console.log(html);
<?php
$ch = curl_init('https://api.floppydata.net/v2/web-data/fetch');
curl_setopt($ch, CURLOPT_POST, true);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
curl_setopt($ch, CURLOPT_HTTPHEADER, [
'Content-Type: application/json',
'X-Api-Key: YOUR_API_KEY',
]);
curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode([
'url' => 'https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States',
'countryCode' => 'US',
'city' => 'New York',
'difficulty' => 'auto',
]));
$response = curl_exec($ch);
curl_close($ch);
echo $response;
package main
import (
"fmt"
"io"
"net/http"
"strings"
)
func main() {
url := "https://api.floppydata.net/v2/web-data/fetch"
payload := strings.NewReader(`{"url":"https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States","countryCode":"US","city":"New York","difficulty":"auto"}`)
req, _ := http.NewRequest("POST", url, payload)
req.Header.Add("Content-Type", "application/json")
req.Header.Add("X-Api-Key", "YOUR_API_KEY")
res, _ := http.DefaultClient.Do(req)
defer res.Body.Close()
body, _ := io.ReadAll(res.Body)
fmt.Println(string(body))
}
{
"html": "<!doctype html><html><head><title>…</title></head><body>…</body></html>",
"sourceUrl": "https://www.google.com/search?q=best+trail+running+shoes",
"fetchedAt": "2026-08-17T12:00:00.000Z"
}
{
"html": "<!doctype html><html><head><title>…</title></head><body>…</body></html>",
"sourceUrl": "https://www.amazon.com/dp/B0C1000XWH",
"fetchedAt": "2026-08-17T12:00:00.000Z"
}
{
"html": "<!doctype html><html><head><title>…</title></head><body>…</body></html>",
"sourceUrl": "https://www.reddit.com/search/?q=coffee",
"fetchedAt": "2026-08-17T12:00:00.000Z"
}
{
"html": "<!doctype html><html><head><title>…</title></head><body>…</body></html>",
"sourceUrl": "https://chatgpt.com/?q=weekly+meal+prep+ideas",
"fetchedAt": "2026-08-17T12:00:00.000Z"
}
{
"html": "<!doctype html><html><head><title>…</title></head><body>…</body></html>",
"sourceUrl": "https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States",
"fetchedAt": "2026-08-17T12:00:00.000Z"
}
Exemplo de renderização Resultados de busca Página de produto Posts da comunidade Resposta de IA Vagas de emprego
Google — resultados de busca renderizados pela API de web scraping
Amazon — página de produto renderizada pela API de web scraping
Reddit — posts da comunidade renderizados pela API de web scraping
ChatGPT — resposta de IA renderizada pela API de web scraping
LinkedIn — vagas de emprego renderizadas pela API de web scraping
99.9% taxa de sucesso
195+ países, cidades e ASNs
HTML · JSON · TXT formatos de saída
24/7 suporte

Todos os motivos para escolher a API de web scraping da Floppydata

Acesse qualquer site, automatize o scraping e fique à frente dos sistemas antibot com nosso conjunto de recursos líder do setor.

Resolução automática de CAPTCHA

Contorne bloqueios de sites e sistemas antibot sem esforço.

Log de desafios
Desafio do Cloudflare ✓ resolvido
reCAPTCHA v3 ✓ resolvido
Limite de requisições 429 ✓ nova tentativa

Renderização em navegador real

Carrega as páginas como um navegador de verdade, para que sites dinâmicos retornem dados completos. Com tecnologia Floppydata.

HTML bruto
<div class="product">
  <h1>SuperFast Laptop</h1>
  <span class="price">
    $1,299.99</span>
  <div class="rating"
    data-value="4.8">_
JSON estruturado
{
  "name": "SuperFast Laptop",
  "price": 1299.99,
  "currency": "USD",
  "rating": 4.8
}
Geotargeting global

Geotargeting global

Acesse conteúdo da web de mais de 195 países, cidades e ASNs.

Renderização de JavaScript

Renderização de JavaScript

Extraia dados de sites dinâmicos e com muito JavaScript.

Rotação inteligente de IP e novas tentativas

Rotação inteligente de IP e novas tentativas

A rotação automática e a lógica de novas tentativas mantêm grandes tarefas estáveis.

Sessões persistentes e tratamento de cookies

Sessões persistentes e tratamento de cookies

Mantenha sessões estáveis para fluxos de várias etapas e extração de dados com login.

Uma plataforma para todos os casos de uso

E-commerce

A coleta de dados como um processo contínuo, não uma ação pontual: preços, sortimento e páginas de produtos transformados em conjuntos de dados estruturados e organizados.

  • Monitoramento de preços e sortimento
  • Criação de catálogos de produtos
  • Análise de concorrentes
Teste grátis
99.9% taxa de sucesso
195+ países, cidades e ASNs

Marketing

Acompanhe os concorrentes e as páginas que importam: a API lida com bloqueios, CAPTCHAs e sistemas antibot, enquanto sua equipe recebe o conteúdo.

  • Análise de concorrentes
  • Rastreamento de mudanças em sites
  • Coleta de conteúdo
Teste grátis
195+ países, cidades e ASNs
24/7 suporte

Fintech

Um pipeline estável de dados da web para análises e BI — desempenho confiável mesmo sob alta carga.

  • Rastreamento de mudanças em sites
  • Preparação de conjuntos de dados
  • Monitoramento de preços e sortimento
Teste grátis
99.9% taxa de sucesso
24/7 suporte

Pesquisa de mercado

Transforme páginas desorganizadas em conjuntos de dados estruturados, prontos para análises, BI ou machine learning.

  • Preparação de conjuntos de dados
  • Coleta de conteúdo
  • Monitoramento de preços e sortimento
Teste grátis
HTML · JSON · TXT formatos de saída
195+ países, cidades e ASNs

Compatibilidade total com qualquer fluxo de IA/ML e infraestrutura de dados

Use a Floppydata em pipelines de treinamento de modelos, agentes de scraping, automação de navegador, jobs de ETL e stacks de análise sem mudar a forma como sua equipe já entrega cargas de trabalho com muitos dados.

Como funciona a API de scraping?

Em vez de acessar o site diretamente, a requisição é enviada à API de scraping, que interage com o recurso de destino. Isso reduz o risco de restrições e torna o processo previsível.

Um cenário típico é assim:

  1. 1 você informa a URL e os parâmetros
  2. 2 A API processa a página
  3. 3 retorna os dados em um formato conveniente
  4. 4 as informações entram imediatamente no pipeline de ingestão de dados.
Ciclo de vida da tarefa
$ POST /v2/web-data/fetch {"url": "…", "countryCode": "US"}
✓ queued · task_id=9f3a
→ fetching via US residential IP
→ solving Cloudflare challenge… ok (1.2s)
→ rendering JavaScript… ok
✓ 200 OK — 214 KB received
→ parsed → JSON delivered to your pipeline

Se o projeto exigir escala, conecta-se a API de web crawling, que pode seguir links e coletar dados de vários níveis do site. Para automatizar grandes volumes de dados, utiliza-se uma API de extração de dados sofisticada, que transforma páginas desorganizadas em conjuntos de dados estruturados.

Como resultado, forma-se um pipeline estável de dados da web, que pode ser usado em análises, BI ou machine learning.

Onde a API de extração de dados da web é usada

A API moderna de extração de dados da web não é apenas uma ferramenta de parsing. É um elemento da infraestrutura digital.

Dentro da empresa, essa API de scraping de dados passa a fazer parte da plataforma geral de dados da web. As informações são armazenadas automaticamente e usadas em relatórios ou previsões.

Em projetos de alta carga, a opção é a API de crawling, que permite trabalhar com muitas páginas ao mesmo tempo.

O que observar ao escolher soluções de web scraping

Ao escolher soluções de web scraping, é importante olhar além da velocidade de processamento das requisições. A estabilidade e a previsibilidade do resultado são muito mais importantes.

Vale considerar:

  • Suporte a páginas dinâmicas
  • Capacidade de escalar
  • Preços transparentes da API de web scraping
  • Disponibilidade de teste grátis de web scraping
  • Praticidade da documentação

Se o sistema se integra a um pipeline de dados da web existente sem adaptações complexas, esse é um bom indicador de qualidade.

Teste grátis de web scraping 5 scrapings bem-sucedidos

Planos e preços

Pague apenas pela extração de dados bem-sucedida — sem surpresas e sem taxas ocultas.

Teste Grátis 5 scrapings bem-sucedidos Teste grátis
Básico $9 10 mil scrapings bem-sucedidos Experimente
Enterprise Personalizado Sob medida para as suas necessidades Fale com a equipe

Fácil de começar, mais fácil ainda de escalar

  1. 1

    Defina a URL de destino e conecte-se à API com uma única linha de código

  2. 2

    Edite os parâmetros de crawling e insira sua lógica personalizada usando Python ou JavaScript

  3. 3

    Obtenha os dados do site em arquivos Markdown, texto, HTML ou JSON

Leia a documentação
Exemplo ao vivo · requer X-API-Key
fetch('https://api.floppydata.net/v2/web-data/fetch', {
    method: 'POST',
    headers: {
        'X-Api-Key': 'YOUR_API_KEY',
        'Content-Type': 'application/json'
    },
    body: JSON.stringify({ url: 'https://example.com' })
});
requests.post(
    'https://api.floppydata.net/v2/web-data/fetch',
    headers={
        'X-Api-Key': 'YOUR_API_KEY',
        'Content-Type': 'application/json'
    },
    json={'url': 'https://example.com'}
)
curl -X POST https://api.floppydata.net/v2/web-data/fetch \
  -H "X-Api-Key: $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://example.com"}'

Perguntas frequentes

O que exatamente é web scraping?

Web scraping é a coleta automática de páginas da web. O sistema recebe o código do site e extrai as informações necessárias para uso posterior.

Fazer scraping por meio de uma API é legal?

A coleta de dados abertos geralmente é permitida, mas é importante levar em conta as regras de uso de cada site e a legislação em vigor.

Como usar a API de scraping?

Para usar, basta enviar uma requisição HTTP à API com a URL desejada. O serviço processa a página e devolve os dados estruturados.

O que significa fazer scraping de dados?

Scraping de dados é o processo de coletar e armazenar dados da web para que sejam analisados, usados ou integrados a um sistema posteriormente.