Floppydata Floppydata
Inicio Web scraping

API de web scraping

Envía una URL y obtén la página tal como la ve un navegador real: JavaScript renderizado, CAPTCHAs resueltos y reintentos de las solicitudes fallidas con grupos de proxies más potentes. Pagas solo por las solicitudes de scraping exitosas.

  • Gestiona automáticamente bloqueos, CAPTCHA y sistemas antibot
  • Obtén el HTML totalmente renderizado de cualquier página pública con una sola llamada a la API
  • SDK oficiales de TypeScript y Python, un servidor MCP para agentes de IA y asistencia 24/7
Sitios populares

Sirve cualquier URL pública; estos son solo ajustes predefinidos.
curl https://api.floppydata.net/v2/web-data/fetch \
--request POST \
--header 'Content-Type: application/json' \
--header 'X-Api-Key: YOUR_API_KEY' \
--data '{
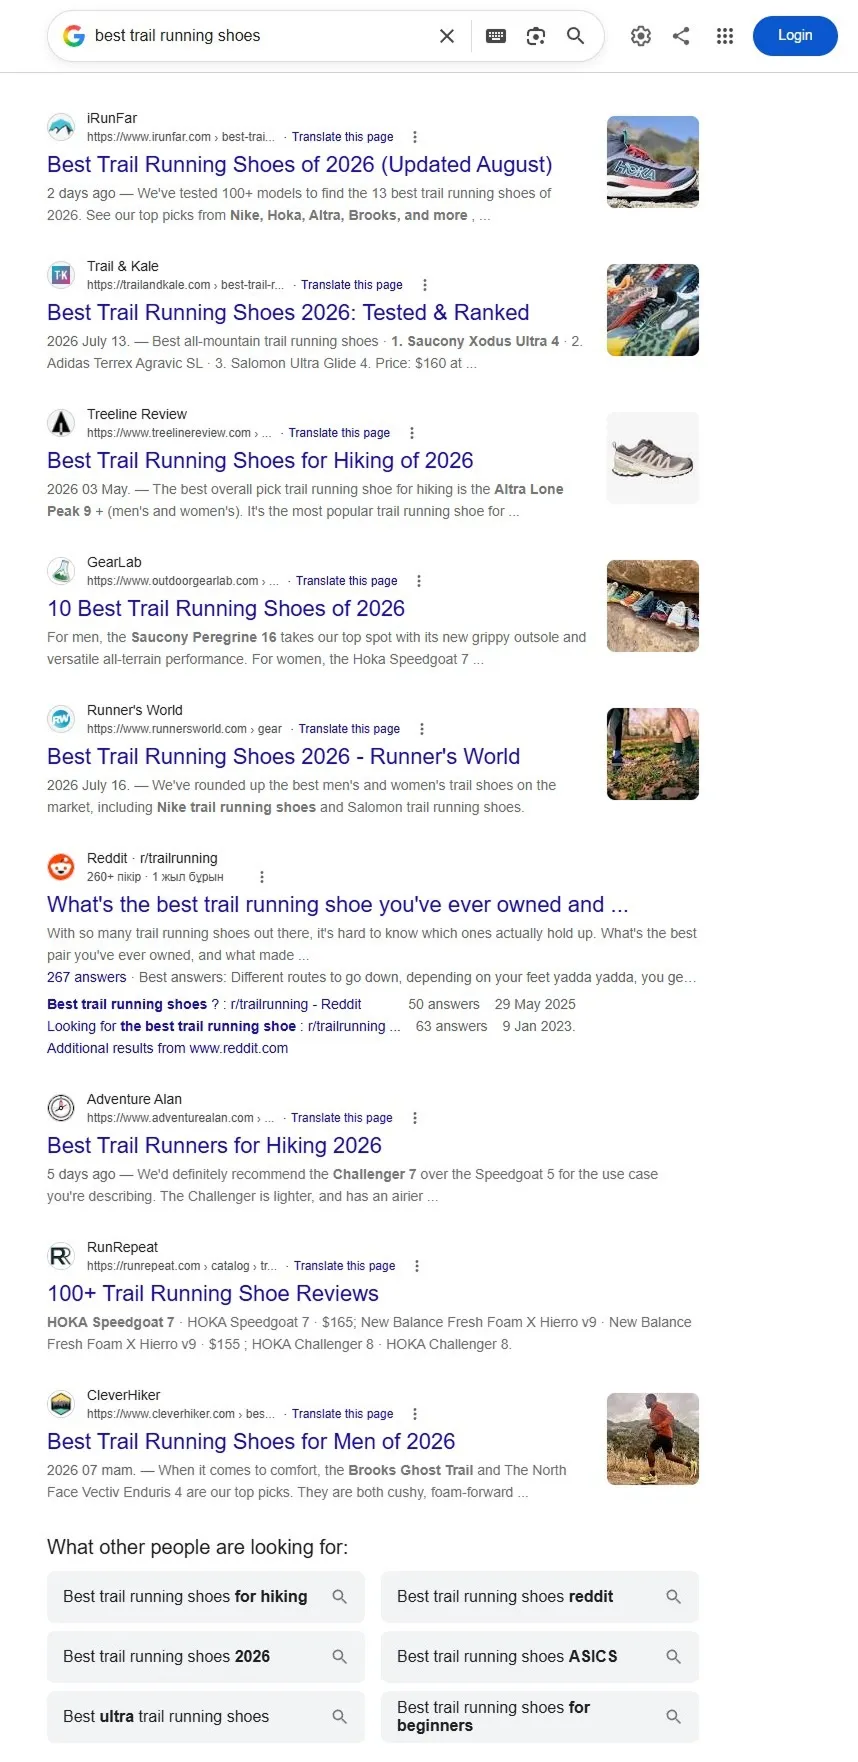
"url": "https://www.google.com/search?q=best+trail+running+shoes",
"countryCode": "US",
"city": "New York",
"difficulty": "auto"
}'
import httpx
response = httpx.post(
"https://api.floppydata.net/v2/web-data/fetch",
headers={
"Content-Type": "application/json",
"X-Api-Key": "YOUR_API_KEY",
},
json={
"url": "https://www.google.com/search?q=best+trail+running+shoes",
"countryCode": "US",
"city": "New York",
"difficulty": "auto",
},
)
data = response.json()
print(data["html"])
const response = await fetch('https://api.floppydata.net/v2/web-data/fetch', {
method: 'POST',
headers: {
'Content-Type': 'application/json',
'X-Api-Key': 'YOUR_API_KEY',
},
body: JSON.stringify({
url: 'https://www.google.com/search?q=best+trail+running+shoes',
countryCode: 'US',
city: 'New York',
difficulty: 'auto',
}),
});
const { html } = await response.json();
console.log(html);
<?php
$ch = curl_init('https://api.floppydata.net/v2/web-data/fetch');
curl_setopt($ch, CURLOPT_POST, true);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
curl_setopt($ch, CURLOPT_HTTPHEADER, [
'Content-Type: application/json',
'X-Api-Key: YOUR_API_KEY',
]);
curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode([
'url' => 'https://www.google.com/search?q=best+trail+running+shoes',
'countryCode' => 'US',
'city' => 'New York',
'difficulty' => 'auto',
]));
$response = curl_exec($ch);
curl_close($ch);
echo $response;
package main
import (
"fmt"
"io"
"net/http"
"strings"
)
func main() {
url := "https://api.floppydata.net/v2/web-data/fetch"
payload := strings.NewReader(`{"url":"https://www.google.com/search?q=best+trail+running+shoes","countryCode":"US","city":"New York","difficulty":"auto"}`)
req, _ := http.NewRequest("POST", url, payload)
req.Header.Add("Content-Type", "application/json")
req.Header.Add("X-Api-Key", "YOUR_API_KEY")
res, _ := http.DefaultClient.Do(req)
defer res.Body.Close()
body, _ := io.ReadAll(res.Body)
fmt.Println(string(body))
}
curl https://api.floppydata.net/v2/web-data/fetch \
--request POST \
--header 'Content-Type: application/json' \
--header 'X-Api-Key: YOUR_API_KEY' \
--data '{
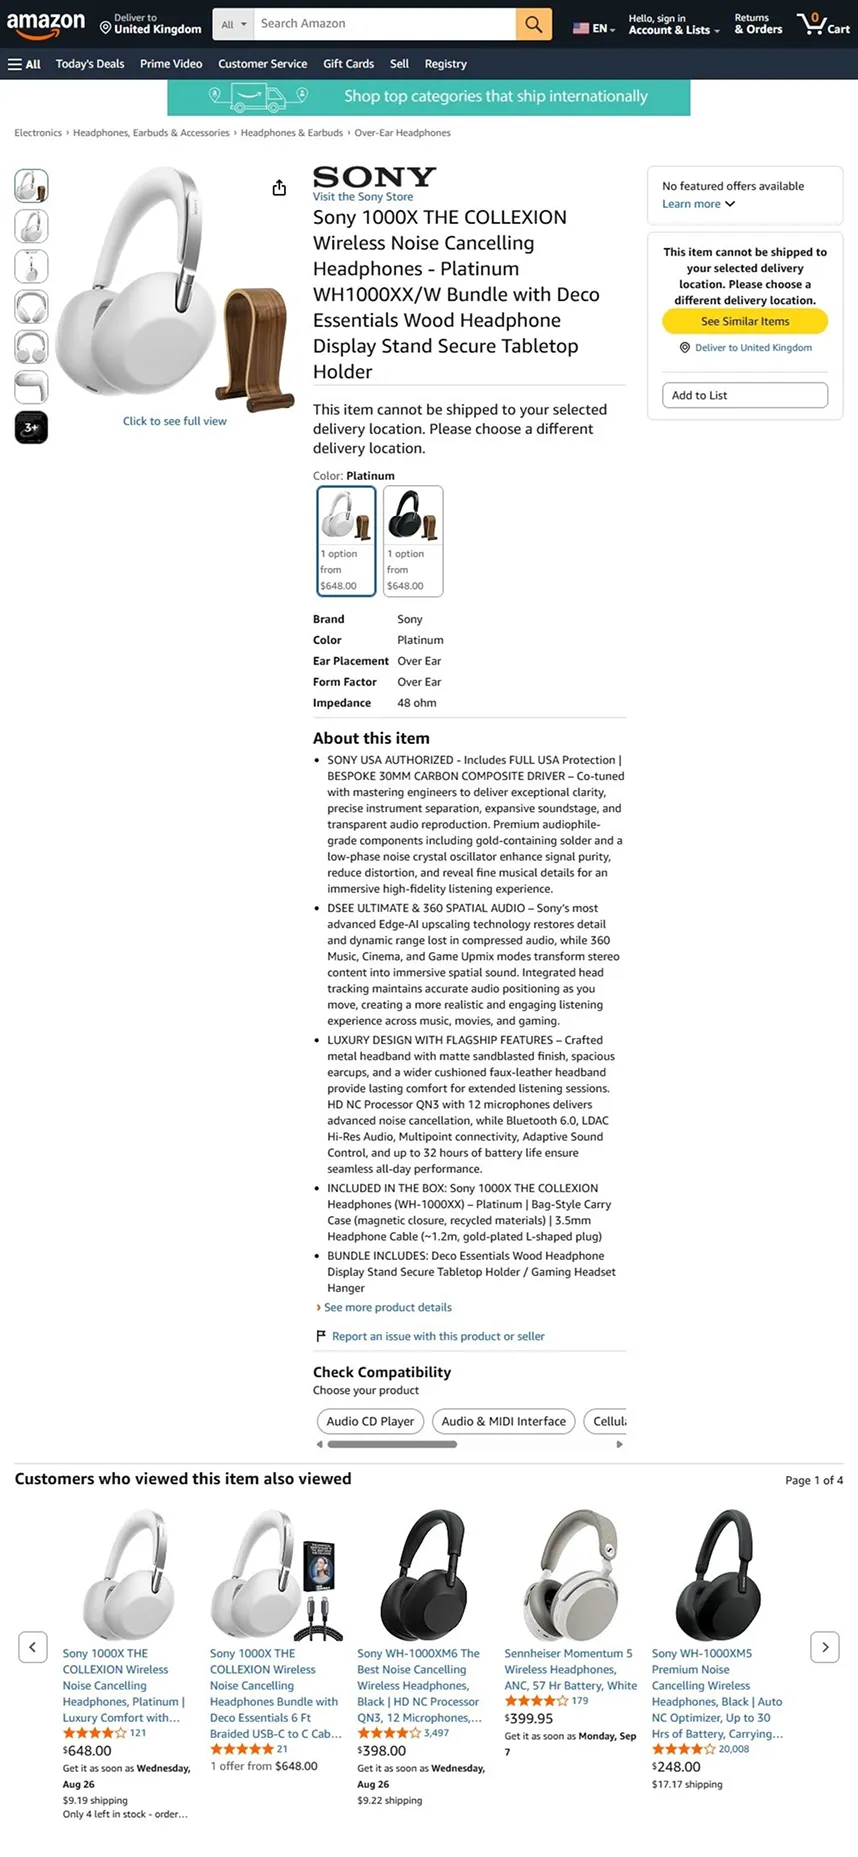
"url": "https://www.amazon.com/dp/B0C1000XWH",
"countryCode": "US",
"city": "New York",
"difficulty": "auto"
}'
import httpx
response = httpx.post(
"https://api.floppydata.net/v2/web-data/fetch",
headers={
"Content-Type": "application/json",
"X-Api-Key": "YOUR_API_KEY",
},
json={
"url": "https://www.amazon.com/dp/B0C1000XWH",
"countryCode": "US",
"city": "New York",
"difficulty": "auto",
},
)
data = response.json()
print(data["html"])
const response = await fetch('https://api.floppydata.net/v2/web-data/fetch', {
method: 'POST',
headers: {
'Content-Type': 'application/json',
'X-Api-Key': 'YOUR_API_KEY',
},
body: JSON.stringify({
url: 'https://www.amazon.com/dp/B0C1000XWH',
countryCode: 'US',
city: 'New York',
difficulty: 'auto',
}),
});
const { html } = await response.json();
console.log(html);
<?php
$ch = curl_init('https://api.floppydata.net/v2/web-data/fetch');
curl_setopt($ch, CURLOPT_POST, true);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
curl_setopt($ch, CURLOPT_HTTPHEADER, [
'Content-Type: application/json',
'X-Api-Key: YOUR_API_KEY',
]);
curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode([
'url' => 'https://www.amazon.com/dp/B0C1000XWH',
'countryCode' => 'US',
'city' => 'New York',
'difficulty' => 'auto',
]));
$response = curl_exec($ch);
curl_close($ch);
echo $response;
package main
import (
"fmt"
"io"
"net/http"
"strings"
)
func main() {
url := "https://api.floppydata.net/v2/web-data/fetch"
payload := strings.NewReader(`{"url":"https://www.amazon.com/dp/B0C1000XWH","countryCode":"US","city":"New York","difficulty":"auto"}`)
req, _ := http.NewRequest("POST", url, payload)
req.Header.Add("Content-Type", "application/json")
req.Header.Add("X-Api-Key", "YOUR_API_KEY")
res, _ := http.DefaultClient.Do(req)
defer res.Body.Close()
body, _ := io.ReadAll(res.Body)
fmt.Println(string(body))
}
curl https://api.floppydata.net/v2/web-data/fetch \
--request POST \
--header 'Content-Type: application/json' \
--header 'X-Api-Key: YOUR_API_KEY' \
--data '{
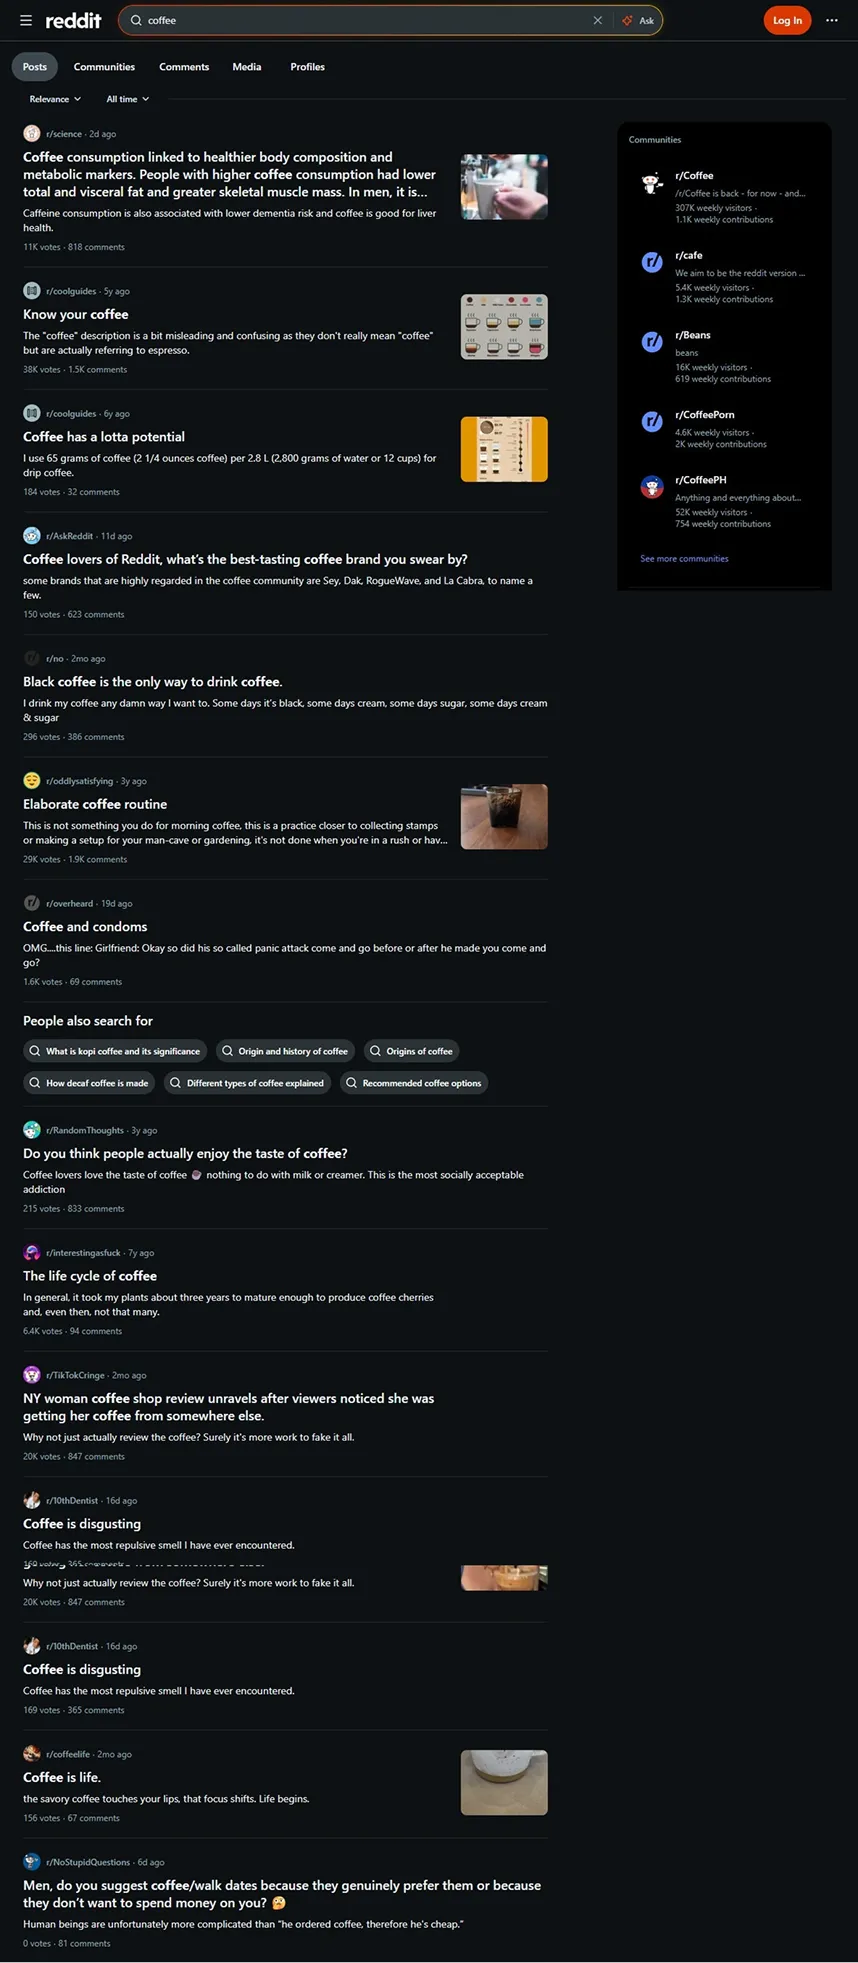
"url": "https://www.reddit.com/search/?q=coffee",
"countryCode": "US",
"city": "New York",
"difficulty": "auto"
}'
import httpx
response = httpx.post(
"https://api.floppydata.net/v2/web-data/fetch",
headers={
"Content-Type": "application/json",
"X-Api-Key": "YOUR_API_KEY",
},
json={
"url": "https://www.reddit.com/search/?q=coffee",
"countryCode": "US",
"city": "New York",
"difficulty": "auto",
},
)
data = response.json()
print(data["html"])
const response = await fetch('https://api.floppydata.net/v2/web-data/fetch', {
method: 'POST',
headers: {
'Content-Type': 'application/json',
'X-Api-Key': 'YOUR_API_KEY',
},
body: JSON.stringify({
url: 'https://www.reddit.com/search/?q=coffee',
countryCode: 'US',
city: 'New York',
difficulty: 'auto',
}),
});
const { html } = await response.json();
console.log(html);
<?php
$ch = curl_init('https://api.floppydata.net/v2/web-data/fetch');
curl_setopt($ch, CURLOPT_POST, true);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
curl_setopt($ch, CURLOPT_HTTPHEADER, [
'Content-Type: application/json',
'X-Api-Key: YOUR_API_KEY',
]);
curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode([
'url' => 'https://www.reddit.com/search/?q=coffee',
'countryCode' => 'US',
'city' => 'New York',
'difficulty' => 'auto',
]));
$response = curl_exec($ch);
curl_close($ch);
echo $response;
package main
import (
"fmt"
"io"
"net/http"
"strings"
)
func main() {
url := "https://api.floppydata.net/v2/web-data/fetch"
payload := strings.NewReader(`{"url":"https://www.reddit.com/search/?q=coffee","countryCode":"US","city":"New York","difficulty":"auto"}`)
req, _ := http.NewRequest("POST", url, payload)
req.Header.Add("Content-Type", "application/json")
req.Header.Add("X-Api-Key", "YOUR_API_KEY")
res, _ := http.DefaultClient.Do(req)
defer res.Body.Close()
body, _ := io.ReadAll(res.Body)
fmt.Println(string(body))
}
curl https://api.floppydata.net/v2/web-data/fetch \
--request POST \
--header 'Content-Type: application/json' \
--header 'X-Api-Key: YOUR_API_KEY' \
--data '{
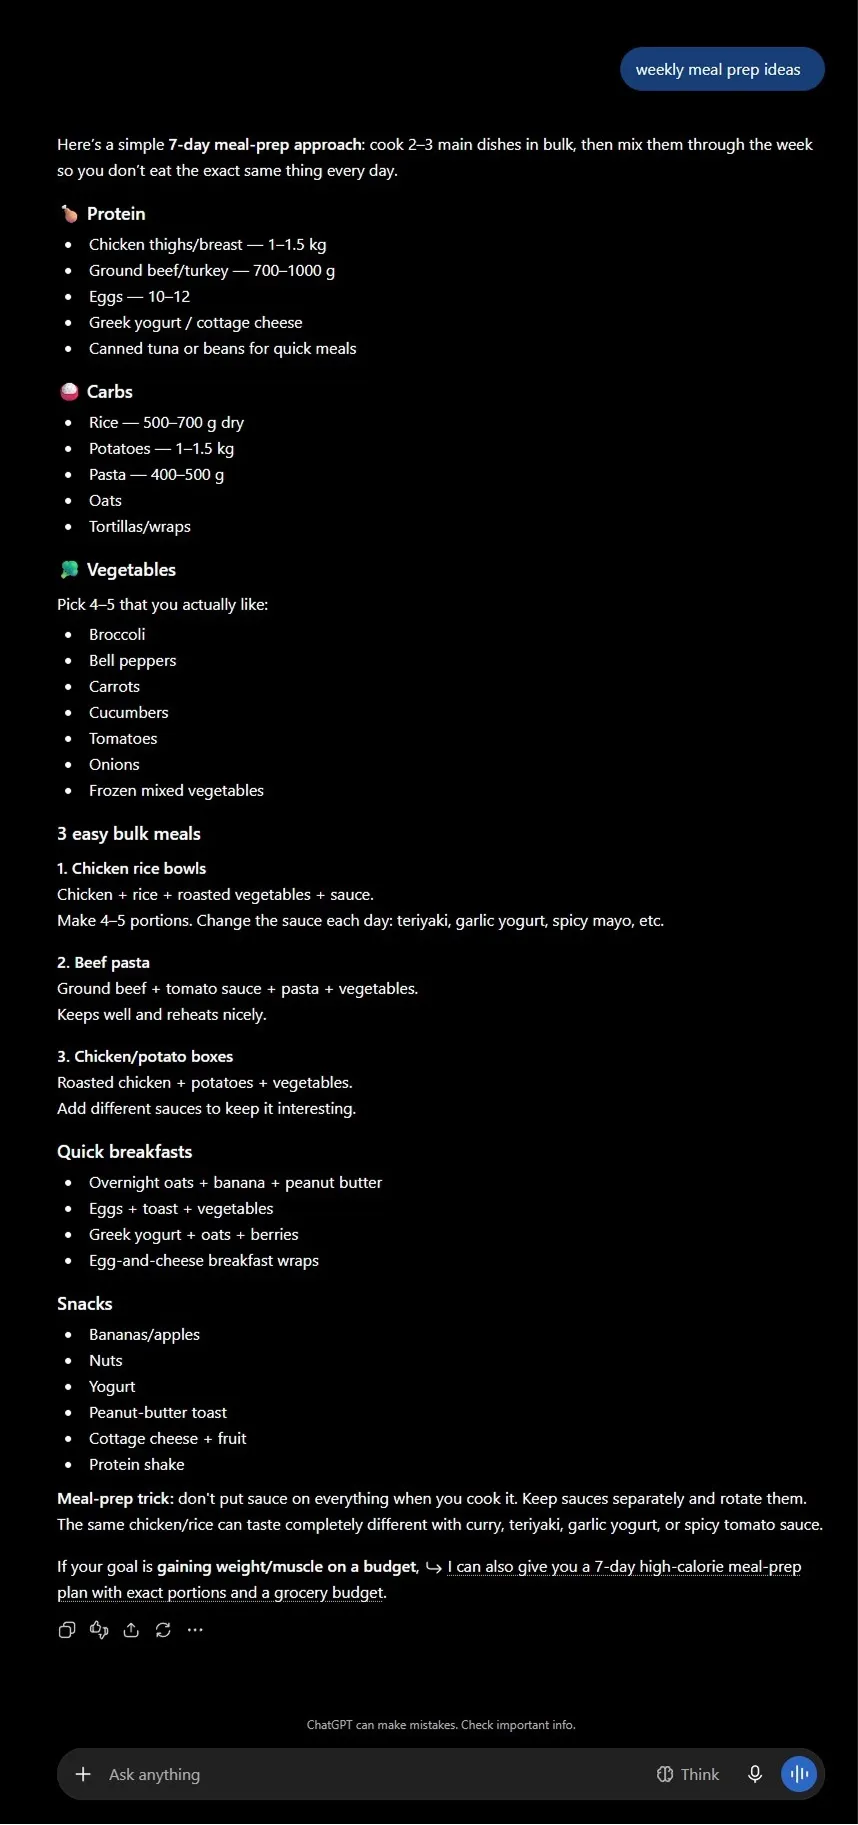
"url": "https://chatgpt.com/?q=weekly+meal+prep+ideas",
"countryCode": "US",
"city": "New York",
"difficulty": "auto"
}'
import httpx
response = httpx.post(
"https://api.floppydata.net/v2/web-data/fetch",
headers={
"Content-Type": "application/json",
"X-Api-Key": "YOUR_API_KEY",
},
json={
"url": "https://chatgpt.com/?q=weekly+meal+prep+ideas",
"countryCode": "US",
"city": "New York",
"difficulty": "auto",
},
)
data = response.json()
print(data["html"])
const response = await fetch('https://api.floppydata.net/v2/web-data/fetch', {
method: 'POST',
headers: {
'Content-Type': 'application/json',
'X-Api-Key': 'YOUR_API_KEY',
},
body: JSON.stringify({
url: 'https://chatgpt.com/?q=weekly+meal+prep+ideas',
countryCode: 'US',
city: 'New York',
difficulty: 'auto',
}),
});
const { html } = await response.json();
console.log(html);
<?php
$ch = curl_init('https://api.floppydata.net/v2/web-data/fetch');
curl_setopt($ch, CURLOPT_POST, true);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
curl_setopt($ch, CURLOPT_HTTPHEADER, [
'Content-Type: application/json',
'X-Api-Key: YOUR_API_KEY',
]);
curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode([
'url' => 'https://chatgpt.com/?q=weekly+meal+prep+ideas',
'countryCode' => 'US',
'city' => 'New York',
'difficulty' => 'auto',
]));
$response = curl_exec($ch);
curl_close($ch);
echo $response;
package main
import (
"fmt"
"io"
"net/http"
"strings"
)
func main() {
url := "https://api.floppydata.net/v2/web-data/fetch"
payload := strings.NewReader(`{"url":"https://chatgpt.com/?q=weekly+meal+prep+ideas","countryCode":"US","city":"New York","difficulty":"auto"}`)
req, _ := http.NewRequest("POST", url, payload)
req.Header.Add("Content-Type", "application/json")
req.Header.Add("X-Api-Key", "YOUR_API_KEY")
res, _ := http.DefaultClient.Do(req)
defer res.Body.Close()
body, _ := io.ReadAll(res.Body)
fmt.Println(string(body))
}
curl https://api.floppydata.net/v2/web-data/fetch \
--request POST \
--header 'Content-Type: application/json' \
--header 'X-Api-Key: YOUR_API_KEY' \
--data '{
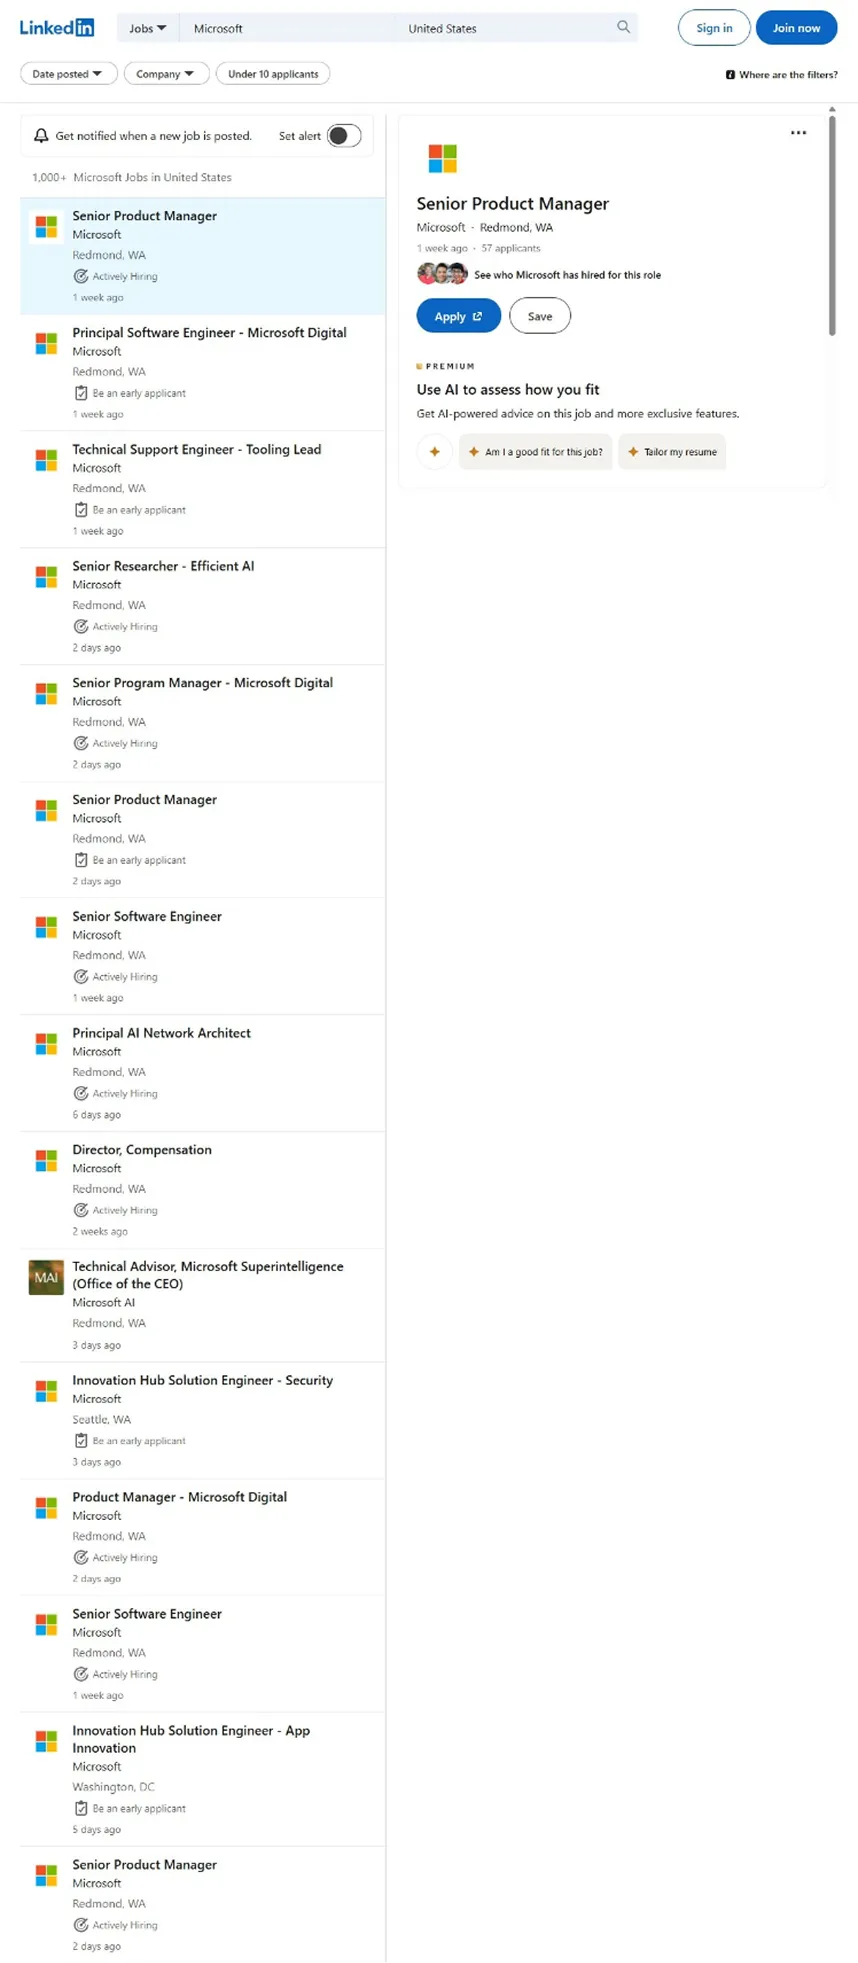
"url": "https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States",
"countryCode": "US",
"city": "New York",
"difficulty": "auto"
}'
import httpx
response = httpx.post(
"https://api.floppydata.net/v2/web-data/fetch",
headers={
"Content-Type": "application/json",
"X-Api-Key": "YOUR_API_KEY",
},
json={
"url": "https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States",
"countryCode": "US",
"city": "New York",
"difficulty": "auto",
},
)
data = response.json()
print(data["html"])
const response = await fetch('https://api.floppydata.net/v2/web-data/fetch', {
method: 'POST',
headers: {
'Content-Type': 'application/json',
'X-Api-Key': 'YOUR_API_KEY',
},
body: JSON.stringify({
url: 'https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States',
countryCode: 'US',
city: 'New York',
difficulty: 'auto',
}),
});
const { html } = await response.json();
console.log(html);
<?php
$ch = curl_init('https://api.floppydata.net/v2/web-data/fetch');
curl_setopt($ch, CURLOPT_POST, true);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
curl_setopt($ch, CURLOPT_HTTPHEADER, [
'Content-Type: application/json',
'X-Api-Key: YOUR_API_KEY',
]);
curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode([
'url' => 'https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States',
'countryCode' => 'US',
'city' => 'New York',
'difficulty' => 'auto',
]));
$response = curl_exec($ch);
curl_close($ch);
echo $response;
package main
import (
"fmt"
"io"
"net/http"
"strings"
)
func main() {
url := "https://api.floppydata.net/v2/web-data/fetch"
payload := strings.NewReader(`{"url":"https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States","countryCode":"US","city":"New York","difficulty":"auto"}`)
req, _ := http.NewRequest("POST", url, payload)
req.Header.Add("Content-Type", "application/json")
req.Header.Add("X-Api-Key", "YOUR_API_KEY")
res, _ := http.DefaultClient.Do(req)
defer res.Body.Close()
body, _ := io.ReadAll(res.Body)
fmt.Println(string(body))
}
{
"html": "<!doctype html><html><head><title>…</title></head><body>…</body></html>",
"sourceUrl": "https://www.google.com/search?q=best+trail+running+shoes",
"fetchedAt": "2026-08-17T12:00:00.000Z"
}
{
"html": "<!doctype html><html><head><title>…</title></head><body>…</body></html>",
"sourceUrl": "https://www.amazon.com/dp/B0C1000XWH",
"fetchedAt": "2026-08-17T12:00:00.000Z"
}
{
"html": "<!doctype html><html><head><title>…</title></head><body>…</body></html>",
"sourceUrl": "https://www.reddit.com/search/?q=coffee",
"fetchedAt": "2026-08-17T12:00:00.000Z"
}
{
"html": "<!doctype html><html><head><title>…</title></head><body>…</body></html>",
"sourceUrl": "https://chatgpt.com/?q=weekly+meal+prep+ideas",
"fetchedAt": "2026-08-17T12:00:00.000Z"
}
{
"html": "<!doctype html><html><head><title>…</title></head><body>…</body></html>",
"sourceUrl": "https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States",
"fetchedAt": "2026-08-17T12:00:00.000Z"
}
Ejemplo de renderizado Resultados de búsqueda Página de producto Publicaciones de la comunidad Respuesta de IA Ofertas de empleo
Google — resultados de búsqueda renderizados por la API de web scraping
Amazon — página de producto renderizada por la API de web scraping
Reddit — publicaciones de la comunidad renderizadas por la API de web scraping
ChatGPT — respuesta de IA renderizada por la API de web scraping
LinkedIn — ofertas de empleo renderizadas por la API de web scraping
$0 por las solicitudes fallidas
207 países, además de segmentación por ciudad
5 solicitudes de scraping gratis para empezar
24/7 asistencia

Todos los motivos para elegir la API de web scraping de Floppydata

Desbloquea cualquier sitio web, automatiza el scraping y mantente por delante de los sistemas antibot con nuestro conjunto de funciones líder del sector.

Resolución automática de CAPTCHA

Elude sin esfuerzo los bloqueos de sitios web y los sistemas antibot.

Registro de desafíos
Desafío de Cloudflare ✓ resuelto
reCAPTCHA v3 ✓ resuelto
Límite de frecuencia 429 ✓ reintentado

Renderizado con navegador real

Carga las páginas como lo hace un navegador real, para que los sitios dinámicos devuelvan datos completos. Con tecnología de Floppydata.

HTML sin procesar
<div class="product">
  <h1>SuperFast Laptop</h1>
  <span class="price">
    $1,299.99</span>
  <div class="rating"
    data-value="4.8">_
JSON analizado
{
  "name": "SuperFast Laptop",
  "price": 1299.99,
  "currency": "USD",
  "rating": 4.8
}
Segmentación geográfica global

Segmentación geográfica global

Elige el país de salida, de entre 207, y la ciudad en cada solicitud.

Renderizado de JavaScript

Renderizado de JavaScript

Extrae datos de sitios web dinámicos y con mucho JavaScript.

Reintentos automáticos, facturados una sola vez

Reintentos automáticos, facturados una sola vez

Un intento fallido se reintenta con grupos de proxies más potentes, hasta 3 veces, y pagas una sola solicitud.

Busca y obtén páginas con una sola clave

Busca y obtén páginas con una sola clave

Busca en Google las páginas que necesitas y luego obtenlas. Cada búsqueda u obtención exitosa cuenta como una solicitud.

Una plataforma para cada caso de uso

E-commerce

La recopilación de datos como proceso continuo, no como una acción puntual: precios, surtido y páginas de producto obtenidos según un calendario y convertidos en conjuntos de datos ordenados.

  • Monitorización de precios y surtido
  • Creación de catálogos de productos
  • Análisis de competidores
Prueba gratis
$0 por las solicitudes fallidas
207 países, además de segmentación por ciudad

Marketing

Vigila a tus competidores y las páginas que importan: la API se encarga de bloqueos, CAPTCHA y sistemas antibot mientras tu equipo recibe el contenido.

  • Análisis de competidores
  • Seguimiento de cambios en sitios web
  • Recopilación de contenido
Prueba gratis
207 países, además de segmentación por ciudad
24/7 asistencia

Fintech

Un flujo estable de datos web para analítica y BI: los intentos fallidos se reintentan con grupos de proxies más potentes y nunca se facturan.

  • Seguimiento de cambios en sitios web
  • Preparación de conjuntos de datos
  • Monitorización de precios y surtido
Prueba gratis
$0 por las solicitudes fallidas
24/7 asistencia

Estudios de mercado

Convierte páginas renderizadas en conjuntos de datos ordenados, listos para analítica, BI o aprendizaje automático.

  • Preparación de conjuntos de datos
  • Recopilación de contenido
  • Monitorización de precios y surtido
Prueba gratis
HTML renderizado en un navegador real
207 países, además de segmentación por ciudad

Compatibilidad total con cualquier flujo de trabajo de IA/ML e infraestructura de datos

Usa Floppydata en pipelines de entrenamiento de modelos, agentes de scraping, automatización de navegadores, procesos ETL y stacks de analítica sin cambiar la forma en que tu equipo ya gestiona cargas de trabajo con muchos datos.

¿Cómo funciona la API de scraping?

En lugar de acceder directamente al sitio, la solicitud se envía a la API de scraping, que es la que interactúa con el recurso objetivo. Esto reduce el riesgo de restricciones y hace que el proceso sea predecible.

Un escenario típico es así:

  1. 1 pasas la URL y los parámetros
  2. 2 la API procesa la página
  3. 3 devuelve el HTML renderizado
  4. 4 la información entra de inmediato en el pipeline de ingesta de datos.
Ciclo de vida de la tarea
$ POST /v2/web-data/fetch {"url": "…", "countryCode": "US"}
✓ queued · task_id=9f3a
→ fetching via US residential IP
→ solving Cloudflare challenge… ok (1.2s)
→ rendering JavaScript… ok
✓ 200 OK — 214 KB received
→ parsed → JSON delivered to your pipeline

Cuando el proyecto crece, envías una solicitud por cada página que necesitas: los enlaces encontrados en una página se convierten en las siguientes solicitudes, lo que te permite recopilar varios niveles de un sitio. Después, tu analizador convierte las páginas renderizadas en conjuntos de datos estructurados y ordenados.

Como resultado, se forma un pipeline de datos web estable que puede usarse en analítica, BI o machine learning.

Dónde se usa la API de extracción de datos web

La API moderna de extracción de datos web no es solo una herramienta de parsing. Es un elemento de la infraestructura digital.

Dentro de la empresa, una API de scraping de datos así pasa a formar parte de la plataforma global de datos web: las páginas que devuelve se almacenan y se usan para informes o previsiones.

Para proyectos de mucha carga, la API acepta una solicitud por cada página que necesitas, y pagas solo por las que tienen éxito.

En qué fijarte al elegir soluciones de web scraping

Al elegir soluciones de web scraping, conviene mirar más allá de la velocidad de procesamiento de las consultas. La estabilidad y la previsibilidad del resultado son mucho más importantes.

Conviene tener en cuenta:

  • Compatibilidad con páginas dinámicas
  • Capacidad de escalar
  • Precios transparentes de la API de web scraping
  • Disponibilidad de una prueba gratuita de web scraping
  • Documentación fácil de usar

Si el sistema se integra en un pipeline de datos web existente sin modificaciones complejas, es un buen indicador de calidad.

Prueba gratuita de web scraping 5 extracciones exitosas

Planes y precios

Paga solo por las extracciones de datos exitosas: sin sorpresas ni cargos ocultos.

Prueba Gratis 5 extracciones exitosas Prueba gratis
Básico $9 10K extracciones exitosas Pruébalo
Enterprise Personalizado Adaptado a tus necesidades Habla con el equipo

Fácil de empezar, más fácil de escalar

  1. 1

    Define la URL de destino y conéctate a la API con una sola línea de código

  2. 2

    Define el país, la ciudad y la dificultad, o llámala desde los SDK de TypeScript y Python

  3. 3

    Recibe el HTML renderizado, con la URL de origen y la hora de obtención

Lee la documentación
Demo en vivo · requiere X-API-Key
fetch('https://api.floppydata.net/v2/web-data/fetch', {
    method: 'POST',
    headers: {
        'X-Api-Key': 'YOUR_API_KEY',
        'Content-Type': 'application/json'
    },
    body: JSON.stringify({ url: 'https://example.com' })
});
requests.post(
    'https://api.floppydata.net/v2/web-data/fetch',
    headers={
        'X-Api-Key': 'YOUR_API_KEY',
        'Content-Type': 'application/json'
    },
    json={'url': 'https://example.com'}
)
curl -X POST https://api.floppydata.net/v2/web-data/fetch \
  -H "X-Api-Key: $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://example.com"}'

Preguntas frecuentes

¿Qué es exactamente el web scraping?

El web scraping es la recopilación automática de páginas web. El sistema recibe el código del sitio y extrae la información necesaria para su uso posterior.

¿Es legal hacer scraping de una API?

La recopilación de datos abiertos suele estar permitida, pero es importante tener en cuenta las normas de uso de cada sitio y la legislación vigente.

¿Cómo se usa una API de scraping?

Para usarla, basta con enviar una solicitud HTTP a la API con la URL que necesitas. El servicio carga la página en un navegador real y devuelve su HTML renderizado.

¿Qué se entiende por scraping de datos?

El scraping de datos es el proceso de recopilar y almacenar datos de la web para revisarlos, utilizarlos o integrarlos más adelante en un sistema.