Floppydata Floppydata
Accueil Web scraping

API de web scraping

Finis les blocages, les CAPTCHA et les requêtes échouées. Collectez sans interruption les données de n'importe quel site. Taux de réussite de 99,9 %.

  • Gérez automatiquement les blocages, les CAPTCHA et les systèmes anti-bot
  • Extrayez des données web complètes — HTML, JSON ou TXT — en un clic
  • Intégration API fluide, taux de réussite de 99,9 % et assistance 24h/24 et 7j/7
Cibles populaires

Toute URL publique fonctionne — ce ne sont que des préréglages.
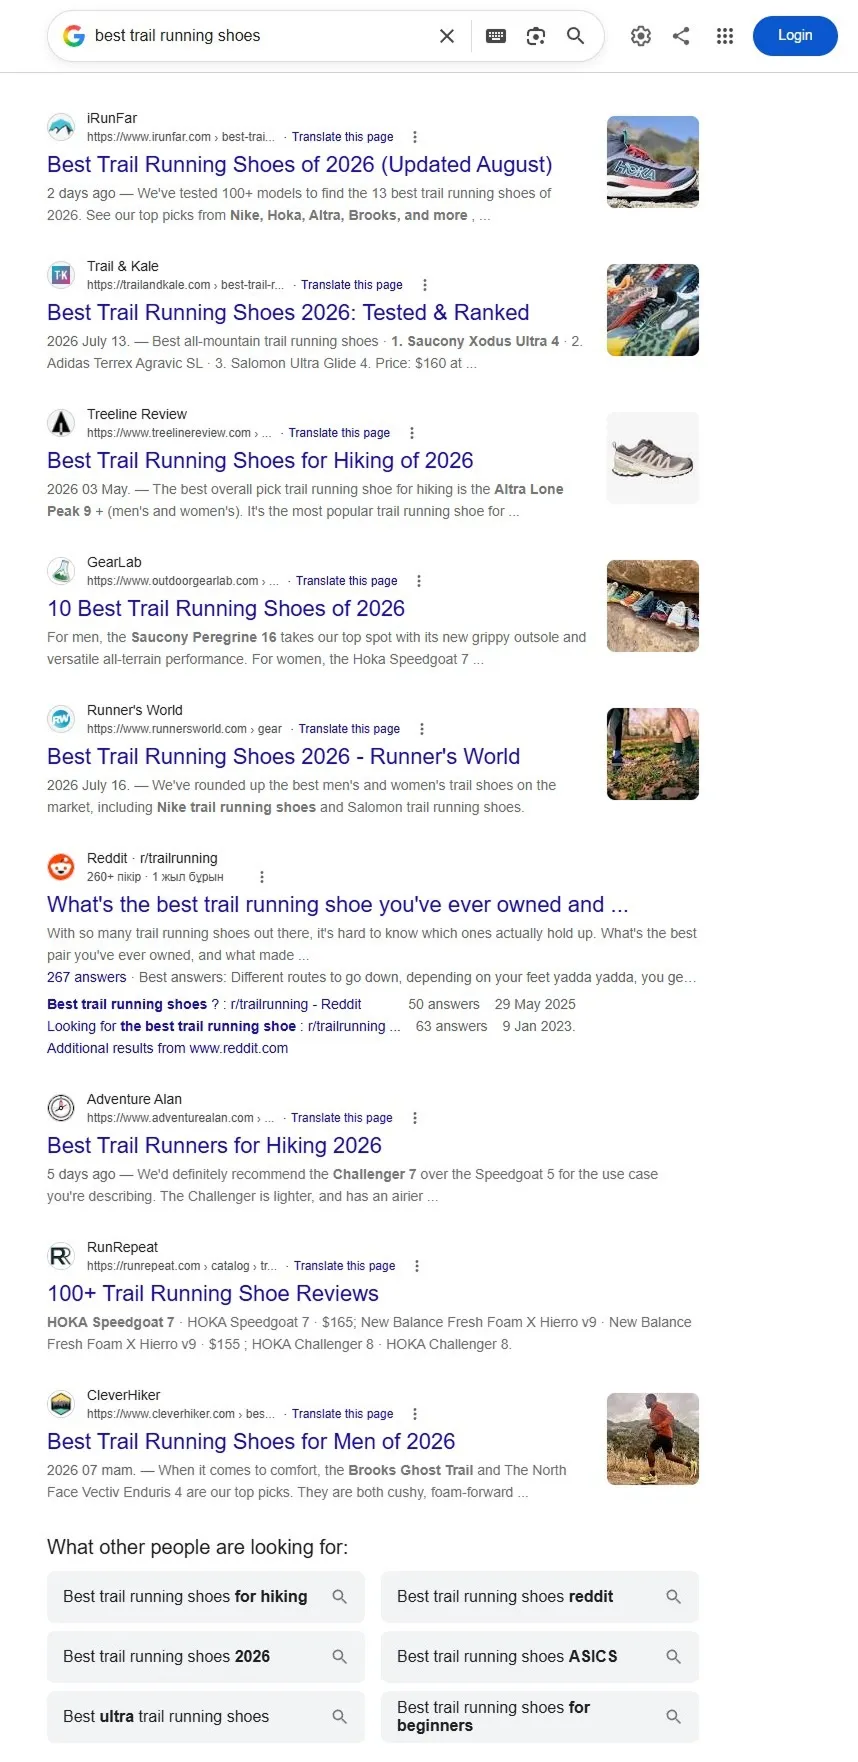
curl https://api.floppydata.net/v2/web-data/fetch \
--request POST \
--header 'Content-Type: application/json' \
--header 'X-Api-Key: YOUR_API_KEY' \
--data '{
"url": "https://www.google.com/search?q=best+trail+running+shoes",
"countryCode": "US",
"city": "New York",
"difficulty": "auto"
}'
import httpx
response = httpx.post(
"https://api.floppydata.net/v2/web-data/fetch",
headers={
"Content-Type": "application/json",
"X-Api-Key": "YOUR_API_KEY",
},
json={
"url": "https://www.google.com/search?q=best+trail+running+shoes",
"countryCode": "US",
"city": "New York",
"difficulty": "auto",
},
)
data = response.json()
print(data["html"])
const response = await fetch('https://api.floppydata.net/v2/web-data/fetch', {
method: 'POST',
headers: {
'Content-Type': 'application/json',
'X-Api-Key': 'YOUR_API_KEY',
},
body: JSON.stringify({
url: 'https://www.google.com/search?q=best+trail+running+shoes',
countryCode: 'US',
city: 'New York',
difficulty: 'auto',
}),
});
const { html } = await response.json();
console.log(html);
<?php
$ch = curl_init('https://api.floppydata.net/v2/web-data/fetch');
curl_setopt($ch, CURLOPT_POST, true);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
curl_setopt($ch, CURLOPT_HTTPHEADER, [
'Content-Type: application/json',
'X-Api-Key: YOUR_API_KEY',
]);
curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode([
'url' => 'https://www.google.com/search?q=best+trail+running+shoes',
'countryCode' => 'US',
'city' => 'New York',
'difficulty' => 'auto',
]));
$response = curl_exec($ch);
curl_close($ch);
echo $response;
package main
import (
"fmt"
"io"
"net/http"
"strings"
)
func main() {
url := "https://api.floppydata.net/v2/web-data/fetch"
payload := strings.NewReader(`{"url":"https://www.google.com/search?q=best+trail+running+shoes","countryCode":"US","city":"New York","difficulty":"auto"}`)
req, _ := http.NewRequest("POST", url, payload)
req.Header.Add("Content-Type", "application/json")
req.Header.Add("X-Api-Key", "YOUR_API_KEY")
res, _ := http.DefaultClient.Do(req)
defer res.Body.Close()
body, _ := io.ReadAll(res.Body)
fmt.Println(string(body))
}
curl https://api.floppydata.net/v2/web-data/fetch \
--request POST \
--header 'Content-Type: application/json' \
--header 'X-Api-Key: YOUR_API_KEY' \
--data '{
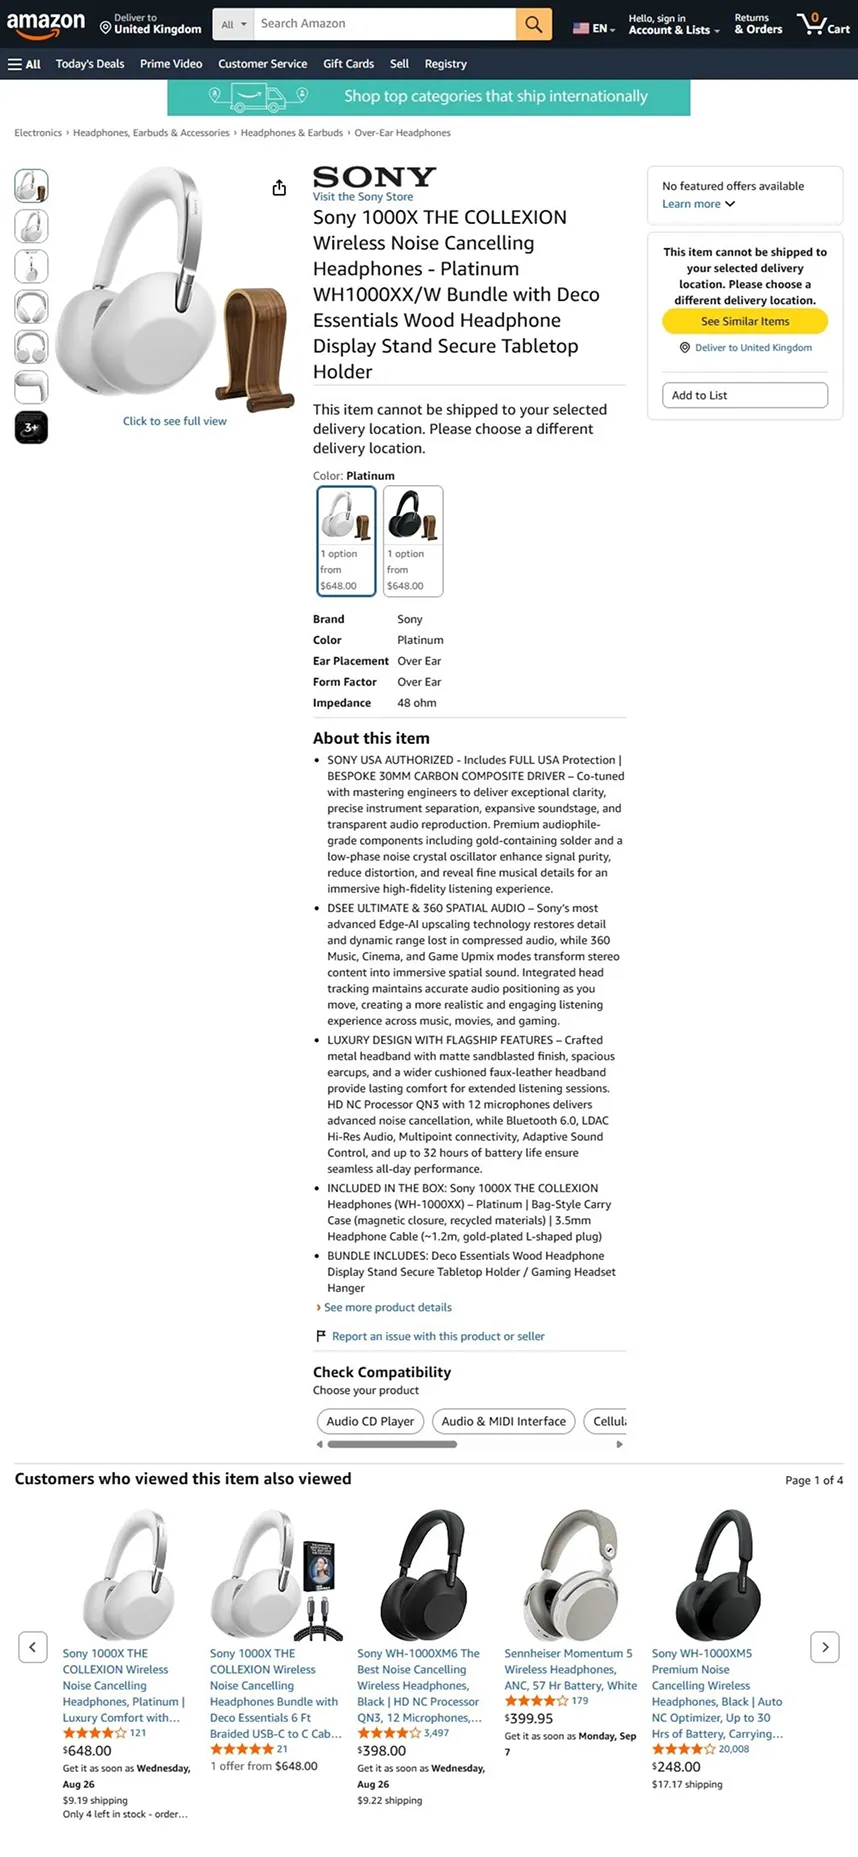
"url": "https://www.amazon.com/dp/B0C1000XWH",
"countryCode": "US",
"city": "New York",
"difficulty": "auto"
}'
import httpx
response = httpx.post(
"https://api.floppydata.net/v2/web-data/fetch",
headers={
"Content-Type": "application/json",
"X-Api-Key": "YOUR_API_KEY",
},
json={
"url": "https://www.amazon.com/dp/B0C1000XWH",
"countryCode": "US",
"city": "New York",
"difficulty": "auto",
},
)
data = response.json()
print(data["html"])
const response = await fetch('https://api.floppydata.net/v2/web-data/fetch', {
method: 'POST',
headers: {
'Content-Type': 'application/json',
'X-Api-Key': 'YOUR_API_KEY',
},
body: JSON.stringify({
url: 'https://www.amazon.com/dp/B0C1000XWH',
countryCode: 'US',
city: 'New York',
difficulty: 'auto',
}),
});
const { html } = await response.json();
console.log(html);
<?php
$ch = curl_init('https://api.floppydata.net/v2/web-data/fetch');
curl_setopt($ch, CURLOPT_POST, true);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
curl_setopt($ch, CURLOPT_HTTPHEADER, [
'Content-Type: application/json',
'X-Api-Key: YOUR_API_KEY',
]);
curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode([
'url' => 'https://www.amazon.com/dp/B0C1000XWH',
'countryCode' => 'US',
'city' => 'New York',
'difficulty' => 'auto',
]));
$response = curl_exec($ch);
curl_close($ch);
echo $response;
package main
import (
"fmt"
"io"
"net/http"
"strings"
)
func main() {
url := "https://api.floppydata.net/v2/web-data/fetch"
payload := strings.NewReader(`{"url":"https://www.amazon.com/dp/B0C1000XWH","countryCode":"US","city":"New York","difficulty":"auto"}`)
req, _ := http.NewRequest("POST", url, payload)
req.Header.Add("Content-Type", "application/json")
req.Header.Add("X-Api-Key", "YOUR_API_KEY")
res, _ := http.DefaultClient.Do(req)
defer res.Body.Close()
body, _ := io.ReadAll(res.Body)
fmt.Println(string(body))
}
curl https://api.floppydata.net/v2/web-data/fetch \
--request POST \
--header 'Content-Type: application/json' \
--header 'X-Api-Key: YOUR_API_KEY' \
--data '{
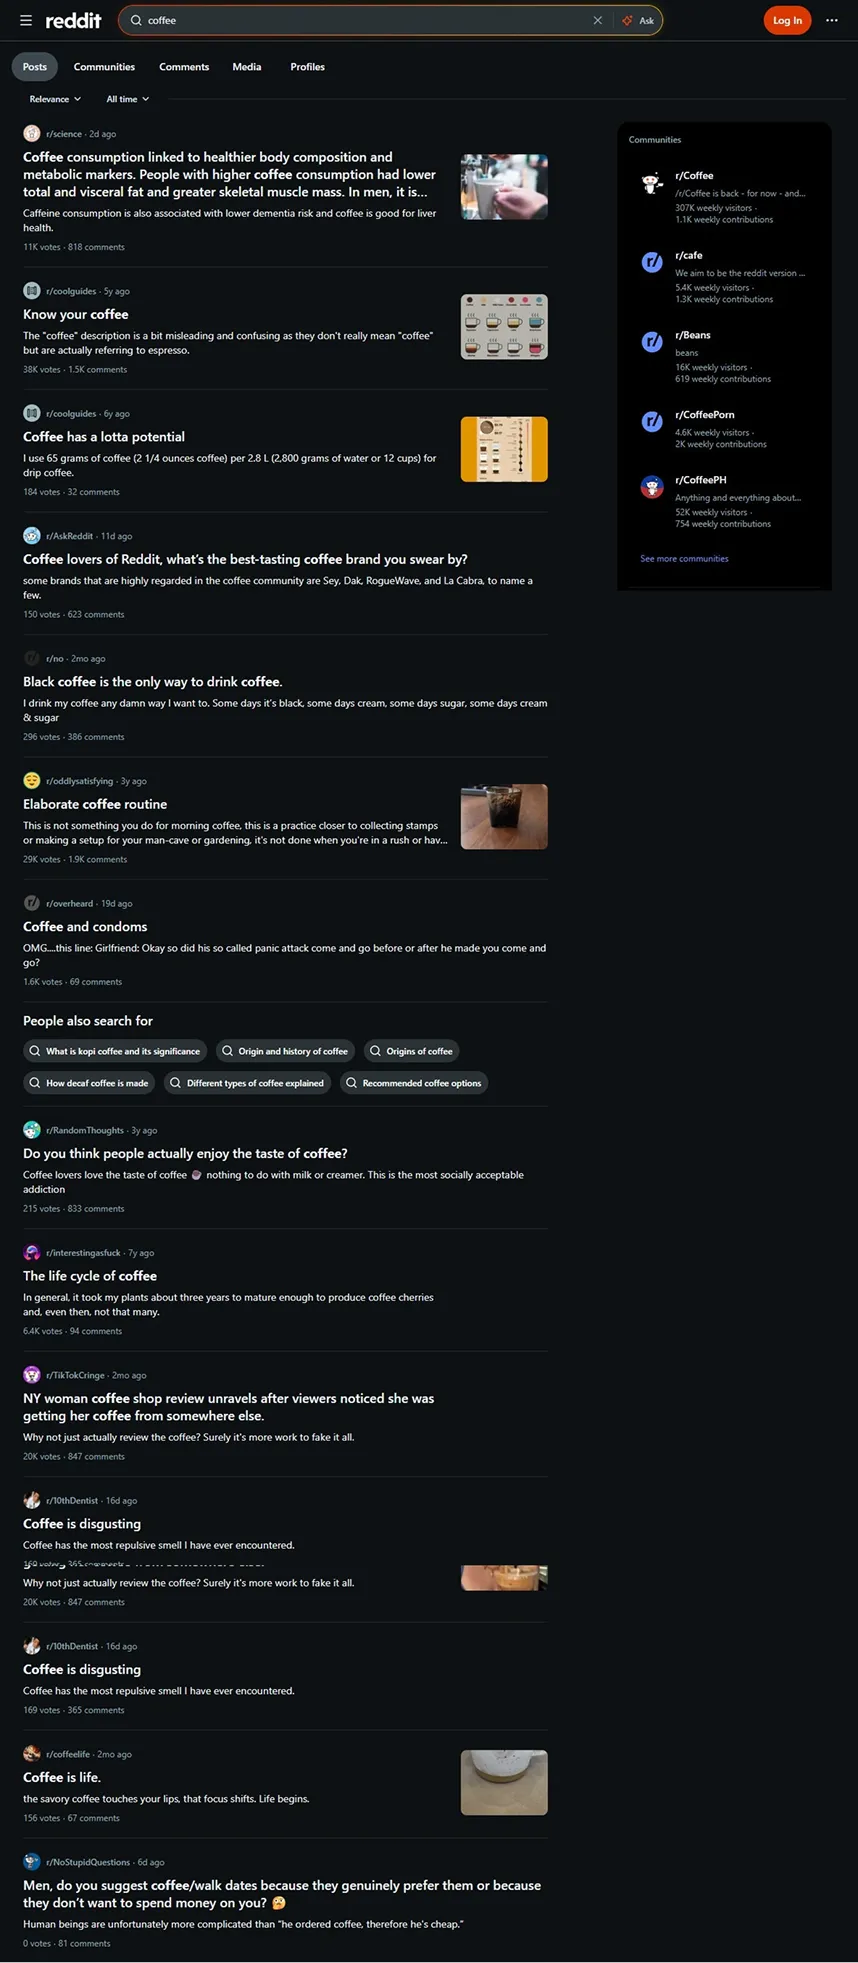
"url": "https://www.reddit.com/search/?q=coffee",
"countryCode": "US",
"city": "New York",
"difficulty": "auto"
}'
import httpx
response = httpx.post(
"https://api.floppydata.net/v2/web-data/fetch",
headers={
"Content-Type": "application/json",
"X-Api-Key": "YOUR_API_KEY",
},
json={
"url": "https://www.reddit.com/search/?q=coffee",
"countryCode": "US",
"city": "New York",
"difficulty": "auto",
},
)
data = response.json()
print(data["html"])
const response = await fetch('https://api.floppydata.net/v2/web-data/fetch', {
method: 'POST',
headers: {
'Content-Type': 'application/json',
'X-Api-Key': 'YOUR_API_KEY',
},
body: JSON.stringify({
url: 'https://www.reddit.com/search/?q=coffee',
countryCode: 'US',
city: 'New York',
difficulty: 'auto',
}),
});
const { html } = await response.json();
console.log(html);
<?php
$ch = curl_init('https://api.floppydata.net/v2/web-data/fetch');
curl_setopt($ch, CURLOPT_POST, true);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
curl_setopt($ch, CURLOPT_HTTPHEADER, [
'Content-Type: application/json',
'X-Api-Key: YOUR_API_KEY',
]);
curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode([
'url' => 'https://www.reddit.com/search/?q=coffee',
'countryCode' => 'US',
'city' => 'New York',
'difficulty' => 'auto',
]));
$response = curl_exec($ch);
curl_close($ch);
echo $response;
package main
import (
"fmt"
"io"
"net/http"
"strings"
)
func main() {
url := "https://api.floppydata.net/v2/web-data/fetch"
payload := strings.NewReader(`{"url":"https://www.reddit.com/search/?q=coffee","countryCode":"US","city":"New York","difficulty":"auto"}`)
req, _ := http.NewRequest("POST", url, payload)
req.Header.Add("Content-Type", "application/json")
req.Header.Add("X-Api-Key", "YOUR_API_KEY")
res, _ := http.DefaultClient.Do(req)
defer res.Body.Close()
body, _ := io.ReadAll(res.Body)
fmt.Println(string(body))
}
curl https://api.floppydata.net/v2/web-data/fetch \
--request POST \
--header 'Content-Type: application/json' \
--header 'X-Api-Key: YOUR_API_KEY' \
--data '{
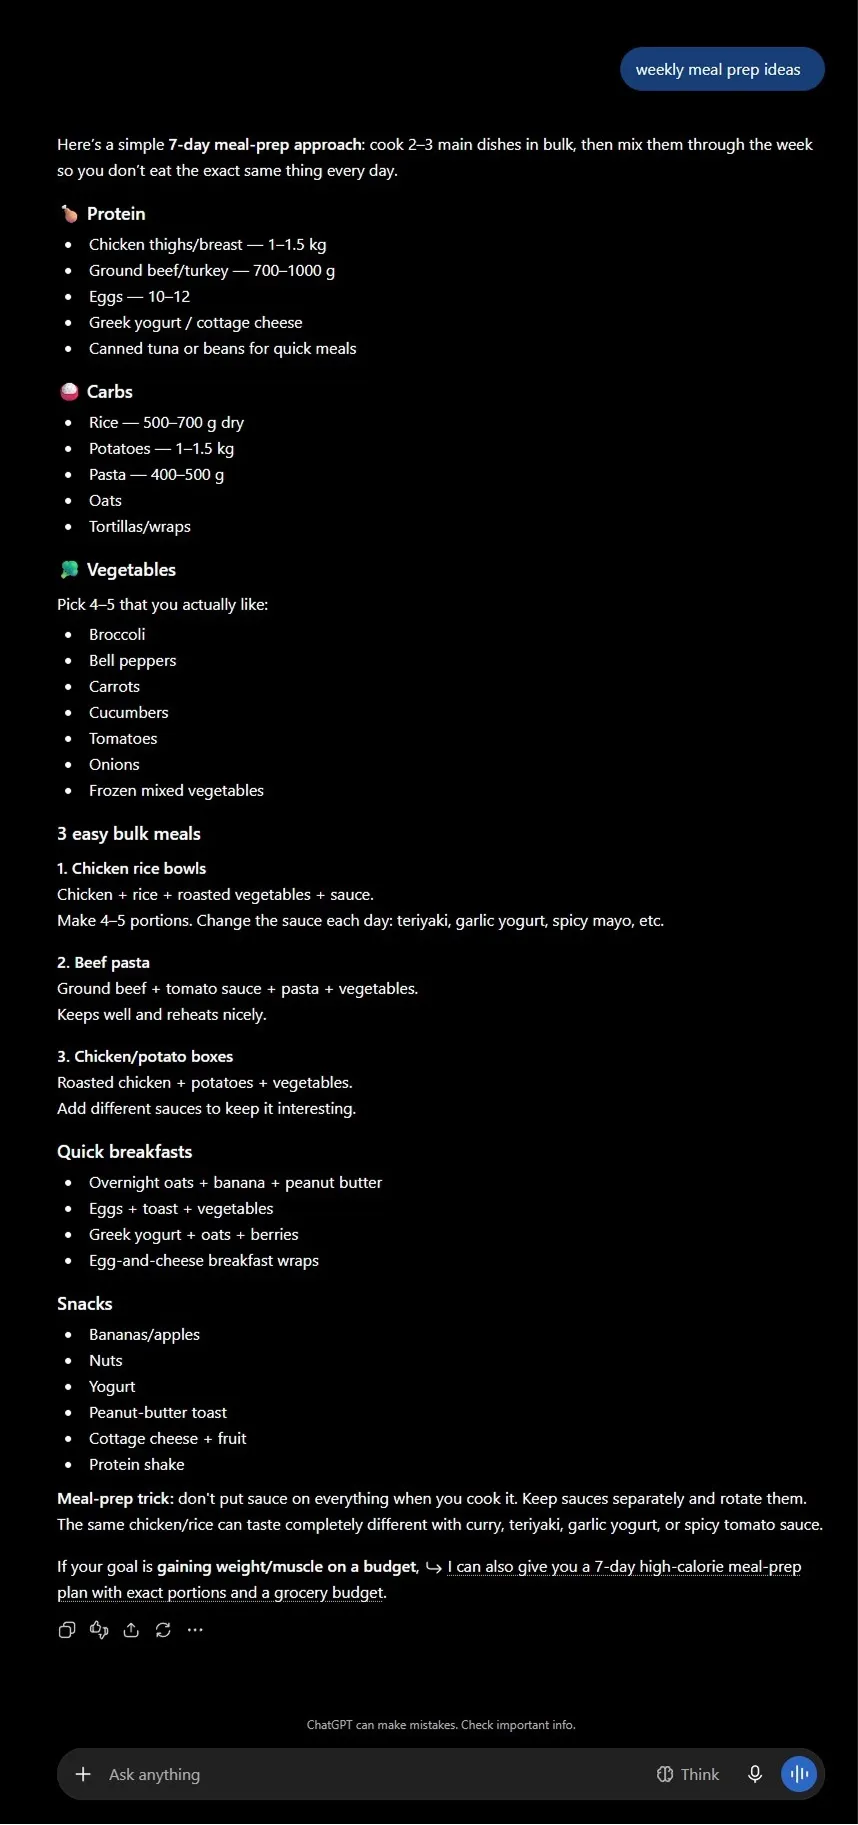
"url": "https://chatgpt.com/?q=weekly+meal+prep+ideas",
"countryCode": "US",
"city": "New York",
"difficulty": "auto"
}'
import httpx
response = httpx.post(
"https://api.floppydata.net/v2/web-data/fetch",
headers={
"Content-Type": "application/json",
"X-Api-Key": "YOUR_API_KEY",
},
json={
"url": "https://chatgpt.com/?q=weekly+meal+prep+ideas",
"countryCode": "US",
"city": "New York",
"difficulty": "auto",
},
)
data = response.json()
print(data["html"])
const response = await fetch('https://api.floppydata.net/v2/web-data/fetch', {
method: 'POST',
headers: {
'Content-Type': 'application/json',
'X-Api-Key': 'YOUR_API_KEY',
},
body: JSON.stringify({
url: 'https://chatgpt.com/?q=weekly+meal+prep+ideas',
countryCode: 'US',
city: 'New York',
difficulty: 'auto',
}),
});
const { html } = await response.json();
console.log(html);
<?php
$ch = curl_init('https://api.floppydata.net/v2/web-data/fetch');
curl_setopt($ch, CURLOPT_POST, true);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
curl_setopt($ch, CURLOPT_HTTPHEADER, [
'Content-Type: application/json',
'X-Api-Key: YOUR_API_KEY',
]);
curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode([
'url' => 'https://chatgpt.com/?q=weekly+meal+prep+ideas',
'countryCode' => 'US',
'city' => 'New York',
'difficulty' => 'auto',
]));
$response = curl_exec($ch);
curl_close($ch);
echo $response;
package main
import (
"fmt"
"io"
"net/http"
"strings"
)
func main() {
url := "https://api.floppydata.net/v2/web-data/fetch"
payload := strings.NewReader(`{"url":"https://chatgpt.com/?q=weekly+meal+prep+ideas","countryCode":"US","city":"New York","difficulty":"auto"}`)
req, _ := http.NewRequest("POST", url, payload)
req.Header.Add("Content-Type", "application/json")
req.Header.Add("X-Api-Key", "YOUR_API_KEY")
res, _ := http.DefaultClient.Do(req)
defer res.Body.Close()
body, _ := io.ReadAll(res.Body)
fmt.Println(string(body))
}
curl https://api.floppydata.net/v2/web-data/fetch \
--request POST \
--header 'Content-Type: application/json' \
--header 'X-Api-Key: YOUR_API_KEY' \
--data '{
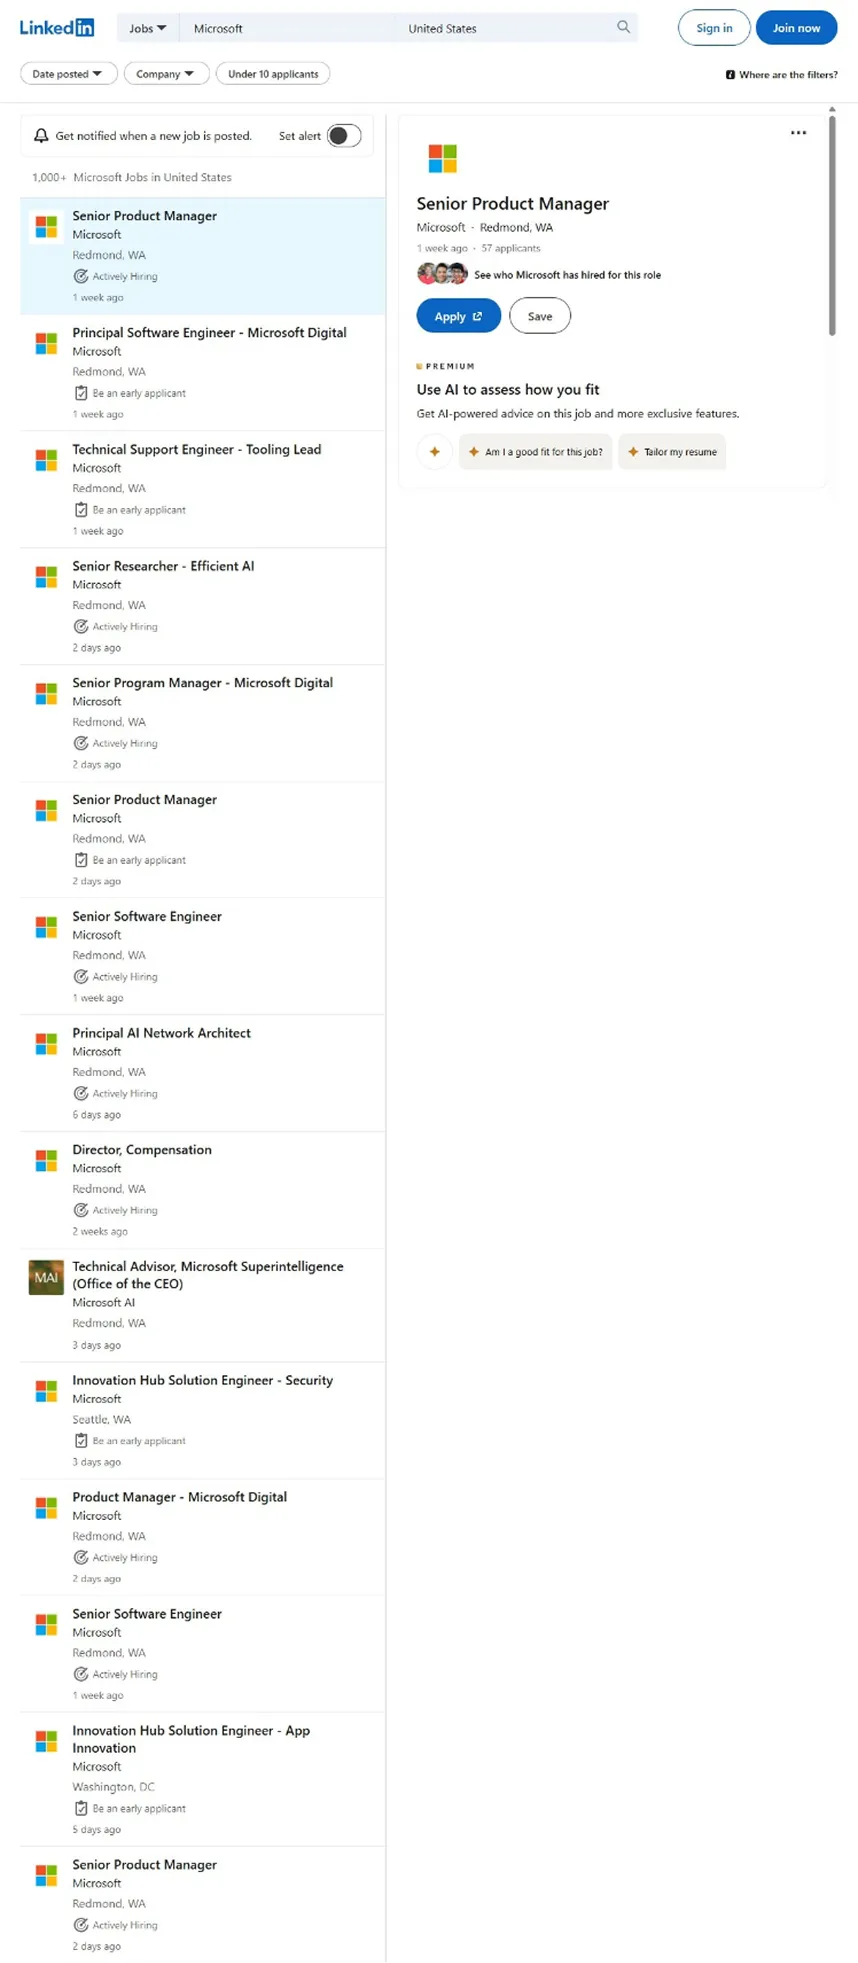
"url": "https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States",
"countryCode": "US",
"city": "New York",
"difficulty": "auto"
}'
import httpx
response = httpx.post(
"https://api.floppydata.net/v2/web-data/fetch",
headers={
"Content-Type": "application/json",
"X-Api-Key": "YOUR_API_KEY",
},
json={
"url": "https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States",
"countryCode": "US",
"city": "New York",
"difficulty": "auto",
},
)
data = response.json()
print(data["html"])
const response = await fetch('https://api.floppydata.net/v2/web-data/fetch', {
method: 'POST',
headers: {
'Content-Type': 'application/json',
'X-Api-Key': 'YOUR_API_KEY',
},
body: JSON.stringify({
url: 'https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States',
countryCode: 'US',
city: 'New York',
difficulty: 'auto',
}),
});
const { html } = await response.json();
console.log(html);
<?php
$ch = curl_init('https://api.floppydata.net/v2/web-data/fetch');
curl_setopt($ch, CURLOPT_POST, true);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
curl_setopt($ch, CURLOPT_HTTPHEADER, [
'Content-Type: application/json',
'X-Api-Key: YOUR_API_KEY',
]);
curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode([
'url' => 'https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States',
'countryCode' => 'US',
'city' => 'New York',
'difficulty' => 'auto',
]));
$response = curl_exec($ch);
curl_close($ch);
echo $response;
package main
import (
"fmt"
"io"
"net/http"
"strings"
)
func main() {
url := "https://api.floppydata.net/v2/web-data/fetch"
payload := strings.NewReader(`{"url":"https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States","countryCode":"US","city":"New York","difficulty":"auto"}`)
req, _ := http.NewRequest("POST", url, payload)
req.Header.Add("Content-Type", "application/json")
req.Header.Add("X-Api-Key", "YOUR_API_KEY")
res, _ := http.DefaultClient.Do(req)
defer res.Body.Close()
body, _ := io.ReadAll(res.Body)
fmt.Println(string(body))
}
{
"html": "<!doctype html><html><head><title>…</title></head><body>…</body></html>",
"sourceUrl": "https://www.google.com/search?q=best+trail+running+shoes",
"fetchedAt": "2026-08-17T12:00:00.000Z"
}
{
"html": "<!doctype html><html><head><title>…</title></head><body>…</body></html>",
"sourceUrl": "https://www.amazon.com/dp/B0C1000XWH",
"fetchedAt": "2026-08-17T12:00:00.000Z"
}
{
"html": "<!doctype html><html><head><title>…</title></head><body>…</body></html>",
"sourceUrl": "https://www.reddit.com/search/?q=coffee",
"fetchedAt": "2026-08-17T12:00:00.000Z"
}
{
"html": "<!doctype html><html><head><title>…</title></head><body>…</body></html>",
"sourceUrl": "https://chatgpt.com/?q=weekly+meal+prep+ideas",
"fetchedAt": "2026-08-17T12:00:00.000Z"
}
{
"html": "<!doctype html><html><head><title>…</title></head><body>…</body></html>",
"sourceUrl": "https://www.linkedin.com/jobs/search/?keywords=microsoft&location=United+States",
"fetchedAt": "2026-08-17T12:00:00.000Z"
}
Exemple de rendu Résultats de recherche Page produit Publications de la communauté Réponse de l'IA Offres d'emploi
Google — Résultats de recherche rendus par l'API de web scraping
Amazon — Page produit rendue par l'API de web scraping
Reddit — Publications de la communauté rendues par l'API de web scraping
ChatGPT — Réponse de l'IA rendue par l'API de web scraping
LinkedIn — Offres d'emploi rendues par l'API de web scraping
99.9% taux de réussite
195+ pays, villes et ASN
HTML · JSON · TXT formats de sortie
24/7 assistance

Toutes les raisons de choisir l'API de web scraping Floppydata

Accédez à n'importe quel site web, automatisez le scraping et gardez une longueur d'avance sur les systèmes anti-bot grâce à notre ensemble de fonctionnalités à la pointe du secteur.

Résolution automatique des CAPTCHA

Contournez sans effort les blocages des sites web et les systèmes anti-bot.

Journal des défis
Défi Cloudflare ✓ résolu
reCAPTCHA v3 ✓ résolu
Limite de débit 429 ✓ nouvelle tentative

Rendu dans un vrai navigateur

Charge les pages comme le ferait un vrai navigateur, afin que les sites dynamiques renvoient des données complètes. Propulsé par Floppydata.

HTML brut
<div class="product">
  <h1>SuperFast Laptop</h1>
  <span class="price">
    $1,299.99</span>
  <div class="rating"
    data-value="4.8">_
JSON analysé
{
  "name": "SuperFast Laptop",
  "price": 1299.99,
  "currency": "USD",
  "rating": 4.8
}
Géociblage mondial

Géociblage mondial

Accédez au contenu web depuis plus de 195 pays, villes et ASN.

Rendu JavaScript

Rendu JavaScript

Extrayez des données de sites web dynamiques et riches en JavaScript.

Rotation d'IP et relances

Rotation d'IP et relances

La rotation automatique et la logique de nouvelles tentatives assurent la stabilité des tâches volumineuses.

Sessions persistantes et gestion des cookies

Sessions persistantes et gestion des cookies

Maintenez des sessions stables pour les parcours en plusieurs étapes et l'extraction de données derrière une connexion.

Une seule plateforme pour tous les cas d'utilisation

E-commerce

La collecte de données comme processus continu, et non comme action ponctuelle : prix, assortiments et pages produit transformés en jeux de données structurés et ordonnés.

  • Suivi des prix et de l'assortiment
  • Création de catalogues de produits
  • Analyse de la concurrence
Essayer gratuitement
99.9% taux de réussite
195+ pays, villes et ASN

Marketing

Surveillez vos concurrents et les pages qui comptent : l'API gère les blocages, les CAPTCHA et les systèmes anti-bot pendant que votre équipe récupère le contenu.

  • Analyse de la concurrence
  • Suivi des modifications sur les sites web
  • Collecte de contenu
Essayer gratuitement
195+ pays, villes et ASN
24/7 assistance

Fintech

Un pipeline de données web stable pour l'analytique et la BI — des performances fiables, même sous forte charge.

  • Suivi des modifications sur les sites web
  • Préparation de jeux de données
  • Suivi des prix et de l'assortiment
Essayer gratuitement
99.9% taux de réussite
24/7 assistance

Étude de marché

Transformez des pages désordonnées en jeux de données structurés et ordonnés, prêts pour l'analytique, la BI ou le machine learning.

  • Préparation de jeux de données
  • Collecte de contenu
  • Suivi des prix et de l'assortiment
Essayer gratuitement
HTML · JSON · TXT formats de sortie
195+ pays, villes et ASN

Compatibilité totale avec tout workflow IA/ML et toute infrastructure de données

Intégrez Floppydata à vos pipelines d'entraînement de modèles, agents de scraping, automatisations de navigateur, jobs ETL et stacks d'analyse, sans changer la façon dont votre équipe livre déjà ses charges de travail gourmandes en données.

Comment fonctionne l'API de scraping ?

Au lieu d'accéder directement au site, la requête est envoyée à l'API de scraping, qui interagit ensuite avec la ressource cible. Cela réduit le risque de restrictions et rend le processus prévisible.

Un scénario type se déroule ainsi :

  1. 1 vous transmettez l'URL et les paramètres
  2. 2 l'API traite la page
  3. 3 renvoie les données dans un format pratique
  4. 4 l'information entre immédiatement dans le pipeline d'ingestion de données.
Cycle de vie d'une tâche
$ POST /v2/web-data/fetch {"url": "…", "countryCode": "US"}
✓ queued · task_id=9f3a
→ fetching via US residential IP
→ solving Cloudflare challenge… ok (1.2s)
→ rendering JavaScript… ok
✓ 200 OK — 214 KB received
→ parsed → JSON delivered to your pipeline

Si le projet nécessite de passer à l'échelle, l'API de crawling web est connectée : elle peut suivre les liens et collecter des données sur plusieurs niveaux du site. Pour automatiser le traitement d'un volume important de données, une API d'extraction de données avancée transforme des pages désordonnées en jeux de données structurés et ordonnés.

Vous obtenez ainsi un pipeline de données web stable, exploitable en analytique, en BI ou en machine learning.

Où l'API d'extraction de données web est utilisée

L'API moderne d'extraction de données web n'est pas un simple outil de parsing. C'est un élément de l'infrastructure numérique.

Au sein de l'entreprise, une telle API de scraping de données s'intègre à la plateforme globale de données web. Les informations sont stockées automatiquement et utilisées pour le reporting ou les prévisions.

Pour les projets à forte charge, on choisit l'API de crawling, qui permet de traiter de nombreuses pages à la fois.

Les critères à examiner pour choisir une solution de web scraping

Lorsque vous choisissez une solution de web scraping, il ne faut pas se limiter à la vitesse de traitement des requêtes. La stabilité et la prévisibilité du résultat comptent bien davantage.

Il convient de prendre en compte :

  • La prise en charge des pages dynamiques
  • La capacité à passer à l'échelle
  • Une tarification transparente de l'API de web scraping
  • La disponibilité d'un essai gratuit de web scraping
  • La clarté de la documentation

Si le système s'intègre à un pipeline de données web existant sans adaptations complexes, c'est un bon indicateur de qualité.

Essai gratuit de web scraping 5 scrapings réussis

Plans et tarification

Ne payez que les extractions de données réussies : pas de surprises, pas de frais cachés.

Essai Gratuit 5 scrapings réussis Essayer gratuitement
Basique $9 10 000 scrapings réussis Essayer
Entreprise Sur mesure Adapté à vos besoins Contacter l'équipe

Facile à lancer, plus facile à étendre

  1. 1

    Définissez l'URL cible et connectez-vous à l'API en une seule ligne de code

  2. 2

    Modifiez les paramètres de crawl et ajoutez votre propre logique en Python ou en JavaScript

  3. 3

    Récupérez les données du site sous forme de fichiers Markdown, texte, HTML ou JSON

Lire la documentation
Démo en direct · X-API-Key requis
fetch('https://api.floppydata.net/v2/web-data/fetch', {
    method: 'POST',
    headers: {
        'X-Api-Key': 'YOUR_API_KEY',
        'Content-Type': 'application/json'
    },
    body: JSON.stringify({ url: 'https://example.com' })
});
requests.post(
    'https://api.floppydata.net/v2/web-data/fetch',
    headers={
        'X-Api-Key': 'YOUR_API_KEY',
        'Content-Type': 'application/json'
    },
    json={'url': 'https://example.com'}
)
curl -X POST https://api.floppydata.net/v2/web-data/fetch \
  -H "X-Api-Key: $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://example.com"}'

Questions fréquentes

Qu'est-ce que le web scraping exactement ?

Le web scraping est une collecte automatique de pages web. Le système récupère le code du site et en extrait les informations nécessaires pour une utilisation ultérieure.

Une API de scraping est-elle légale ?

La collecte de données ouvertes est généralement autorisée, mais il est important de tenir compte des règles d'utilisation du site concerné et de la législation en vigueur.

Comment utiliser une API de scraping ?

Pour l'utiliser, il suffit d'envoyer une requête HTTP à l'API avec l'URL souhaitée. Le service traite la page et renvoie les données structurées.

Que signifie le scraping de données ?

Le scraping de données est le processus de collecte et de stockage de données issues du web, afin de les consulter, de les utiliser ou de les intégrer ultérieurement dans un système.