Зміст
Web Unblocker (або Web Unlocker) — це онлайн-інструмент, який завантажує для вас публічні вебсторінки: рендерить JavaScript, повторює невдалі запити та використовує IP-адреси в потрібній вам країні. Веб-розблокувальник – це набагато більш просунута версія веб-проксі. Замість того щоб просто переспрямовувати запити до URL через іншу IP-адресу, Web Unlocker також завантажує сторінку повністю й повертає її HTML та JSON-дані.
Користувачі зазвичай використовують веб-розблокувальники для автоматизації вилучення даних. У цьому блозі ми детально розглянемо веб-розблокувальники, чим вони відрізняються від проксі-серверів, в яких випадках вони використовуються і як налаштувати автоматизацію веб-скрепінгу за допомогою надійного API веб-розблокувальника. Давайте зануримося!
Порівняння: Веб Unblocker та Веб проксі
Звичайний вебсайт-проксі допомагає зайти на вебсайт з іншої IP-адреси: він просто переспрямовує ваш трафік через іншу IP-адресу, і на цьому все. Веб-проксі-сервери, як правило, працюють повільніше, оскільки один і той самий IP-адресу і сервер використовують сотні і тисячі користувачів, які одночасно надсилають кілька запитів. Преміум-версії веб-проксі-серверів працюють швидше, але все одно можуть використовуватися декількома преміум-користувачами.
Веб-розблокувальник робить більше, ніж просто змінює IP-адреси. Він завантажує сторінку у справжньому браузері, чекає на JavaScript і контент із відкладеним завантаженням, а якщо запит не вдався, повторює його з іншої IP-адреси.
Якщо ви користуєтеся розширеним Web Unblocker, як-от Web Unlocker від Floppydata, ви також можете скрапити корисні дані з публічних сторінок, як-от списки товарів, ціни та результати пошуку на eBay, Amazon та інших сайтах. Ці вилучені дані потім очищаються і використовуються для навчання ШІ-моделей, створення інструментів для конкретних платформ та інших обґрунтованих сценаріїв використання.
Варіанти використання Веб Unblocker
Використання веб-обхідників не є незаконним. Законність залежить від того, що ви маєте намір робити з веб-розблокувальниками. Якщо ви збираєте публічні дані, дотримуєтеся умов кожного сайту та robots.txt і не чіпаєте персональні дані, ви на правильному боці. Ось кілька поширених випадків використання веб-розблокувальників.
1. Автоматизація веб-скрепінгу в масштабі
Найпоширеніша сфера використання веб-розблокувальників – це автоматизація веб-скрепінгу. Ви не просто вилучаєте URL-адресу, ви створюєте повну автоматизацію, яка самостійно переглядає налаштовані URL-адреси або домени, вилучає дані з усіх сторінок і фільтрує їх, щоб надати вам потрібні дані.
Коли ви скануєте дані веб-сайту, ви отримуєте HTML-код веб-сторінки. Він включає весь вміст сторінки і те, як він був розміщений. Потім ви можете витягти корисну інформацію з певних полів. Люди виконують веб-скрепінг, щоб поповнити свої інструменти моніторингу цін на товари, відстеження пошукової видачі для SEO, списків нерухомості, дощок оголошень про вакансії та досліджень ринку.
2. QA-тестування та моніторинг
Якщо ви хочете протестувати власну анти-бот-систему вашого сайту або перевірити, чи працює вона в різних регіонах і яку затримку ви отримуєте, веб-розблокувальники є чудовим інструментом. У цьому випадку ви не отримаєте доступ до заблокованого веб-сайту, але ви можете використовувати його функцію автоматизації для проведення автоматичних тестів. Ви навіть можете вказати власні IP-адреси, вибравши проксі-сервери з певних країн або навіть міст.
3. Збір даних для ШІ та аналітики
Моделі машинного навчання потребують тонни даних для навчання. Оскільки компанії віддають перевагу оновленим даним з Інтернету, вони використовують веб-розблокувальники та їхню підтримку API, щоб сканувати веб-сайти, зберігати вміст сторінок, витягувати корисні дані з цих HTML- або JSON-файлів і передавати їх у свою модель для отримання кращих результатів.
Чому веб-сайти блокують вилучення даних?
Якщо вилучення даних є законним, чому компанії застосовують такі жорсткі заходи проти вилучень даних? Якщо ви спробуєте використати скрипт Python для вилучення даних з веб-сторінки, ваша IP-адреса може бути заблокована. Ви більше не зможете отримати доступ до веб-сайту зі свого пристрою. Є кілька причин, чому компанії роблять це, включаючи перевантаження сервера і конфіденційність користувачів.
Компанії не люблять скрепери даних і веб-розблокувальники, тому що вони створюють зайве навантаження на сервери. Типова автоматизація вилучення даних надсилає тисячі запитів до сторінок одночасно, щоб вилучити величезні обсяги даних. Компаніям доводиться платити за навантаження, яке скрепери даних створюють на їхніх серверах.
Захист інтелектуальної власності — ще одна причина. Коли вебсайт витрачає час, ресурси й зусилля, щоб розмістити в мережі автентичний контент, він не хоче, щоб скрапери даних легко отримували його та використовували без дозволу. Так само соціальні мережі захищають приватність користувачів.
Як вебсайти розпізнають автоматизацію скрапінгу
Веб-сайт зазвичай відстежує наступне:
- Кількість запитів за хвилину
- IP-адреса, через яку здійснюються запити
- Відбитки пальців користувача браузера (шрифти, webGL, ОС, часовий пояс і т.д.)
Якщо веб-сайт виявляє спам-активність, він блокує IP-адресу та “відбиток пальця” браузера. Тримайте помірну частоту запитів, дотримуйтеся robots.txt і умов сайту та користуйтеся офіційним API, якщо сайт його пропонує.
Що робить Floppydata Web Unlocker
Floppydata Web Unlocker використовує власний пул ротаційних IP-адрес, щоб завантажувати сторінки за вас. Замість вашої мережевої IP-адреси Floppydata використовує безпечні й чисті проксі з понад 195 країн, тож ви бачите сторінку так, як вона виглядає у вибраній країні чи місті.
Він рендерить JavaScript і контент із відкладеним завантаженням у справжньому браузері. Якщо запит не вдається, він автоматично застосовує логіку повторних спроб і надсилає той самий запит через інший проксі.
Посібник: Як використовувати Floppydata Web Unlocker для автоматизації веб-скрепінгу
Якщо ви досвідчений веб-скрепер, Floppydata Web Unlocker – ідеальний вибір. Він має два режими.
- У додатку скрепер для миттєвого вилучення або будь-якої URL-адреси
- Режим API для масового запуску автоматизації веб-скрепінгу з логікою повторних спроб
Якщо ви хочете отримати вміст однієї веб-сторінки, ви можете скористатися вбудованим розблокувальником Floppydata. Цей метод зазвичай використовується для отримання HTML-вмісту веб-сайтів, щоб проаналізувати, як вони відображають інформацію.
Крок 1: Створіть обліковий запис Floppydata
Зареєструйтеся на Floppydata і відкрийте інформаційну панель. Тут ви можете керувати своїми проксі-серверами та інструментами, такими як веб-розблокувальник.
Крок #2: Створіть пул проксі-серверів
Ви можете придбати проксі з 195+ країн і створити пул проксі для використання. Ви можете або купити статичні IP, або взяти трафік для ротаційних IP, які автоматично змінюватимуться з кожним запитом.
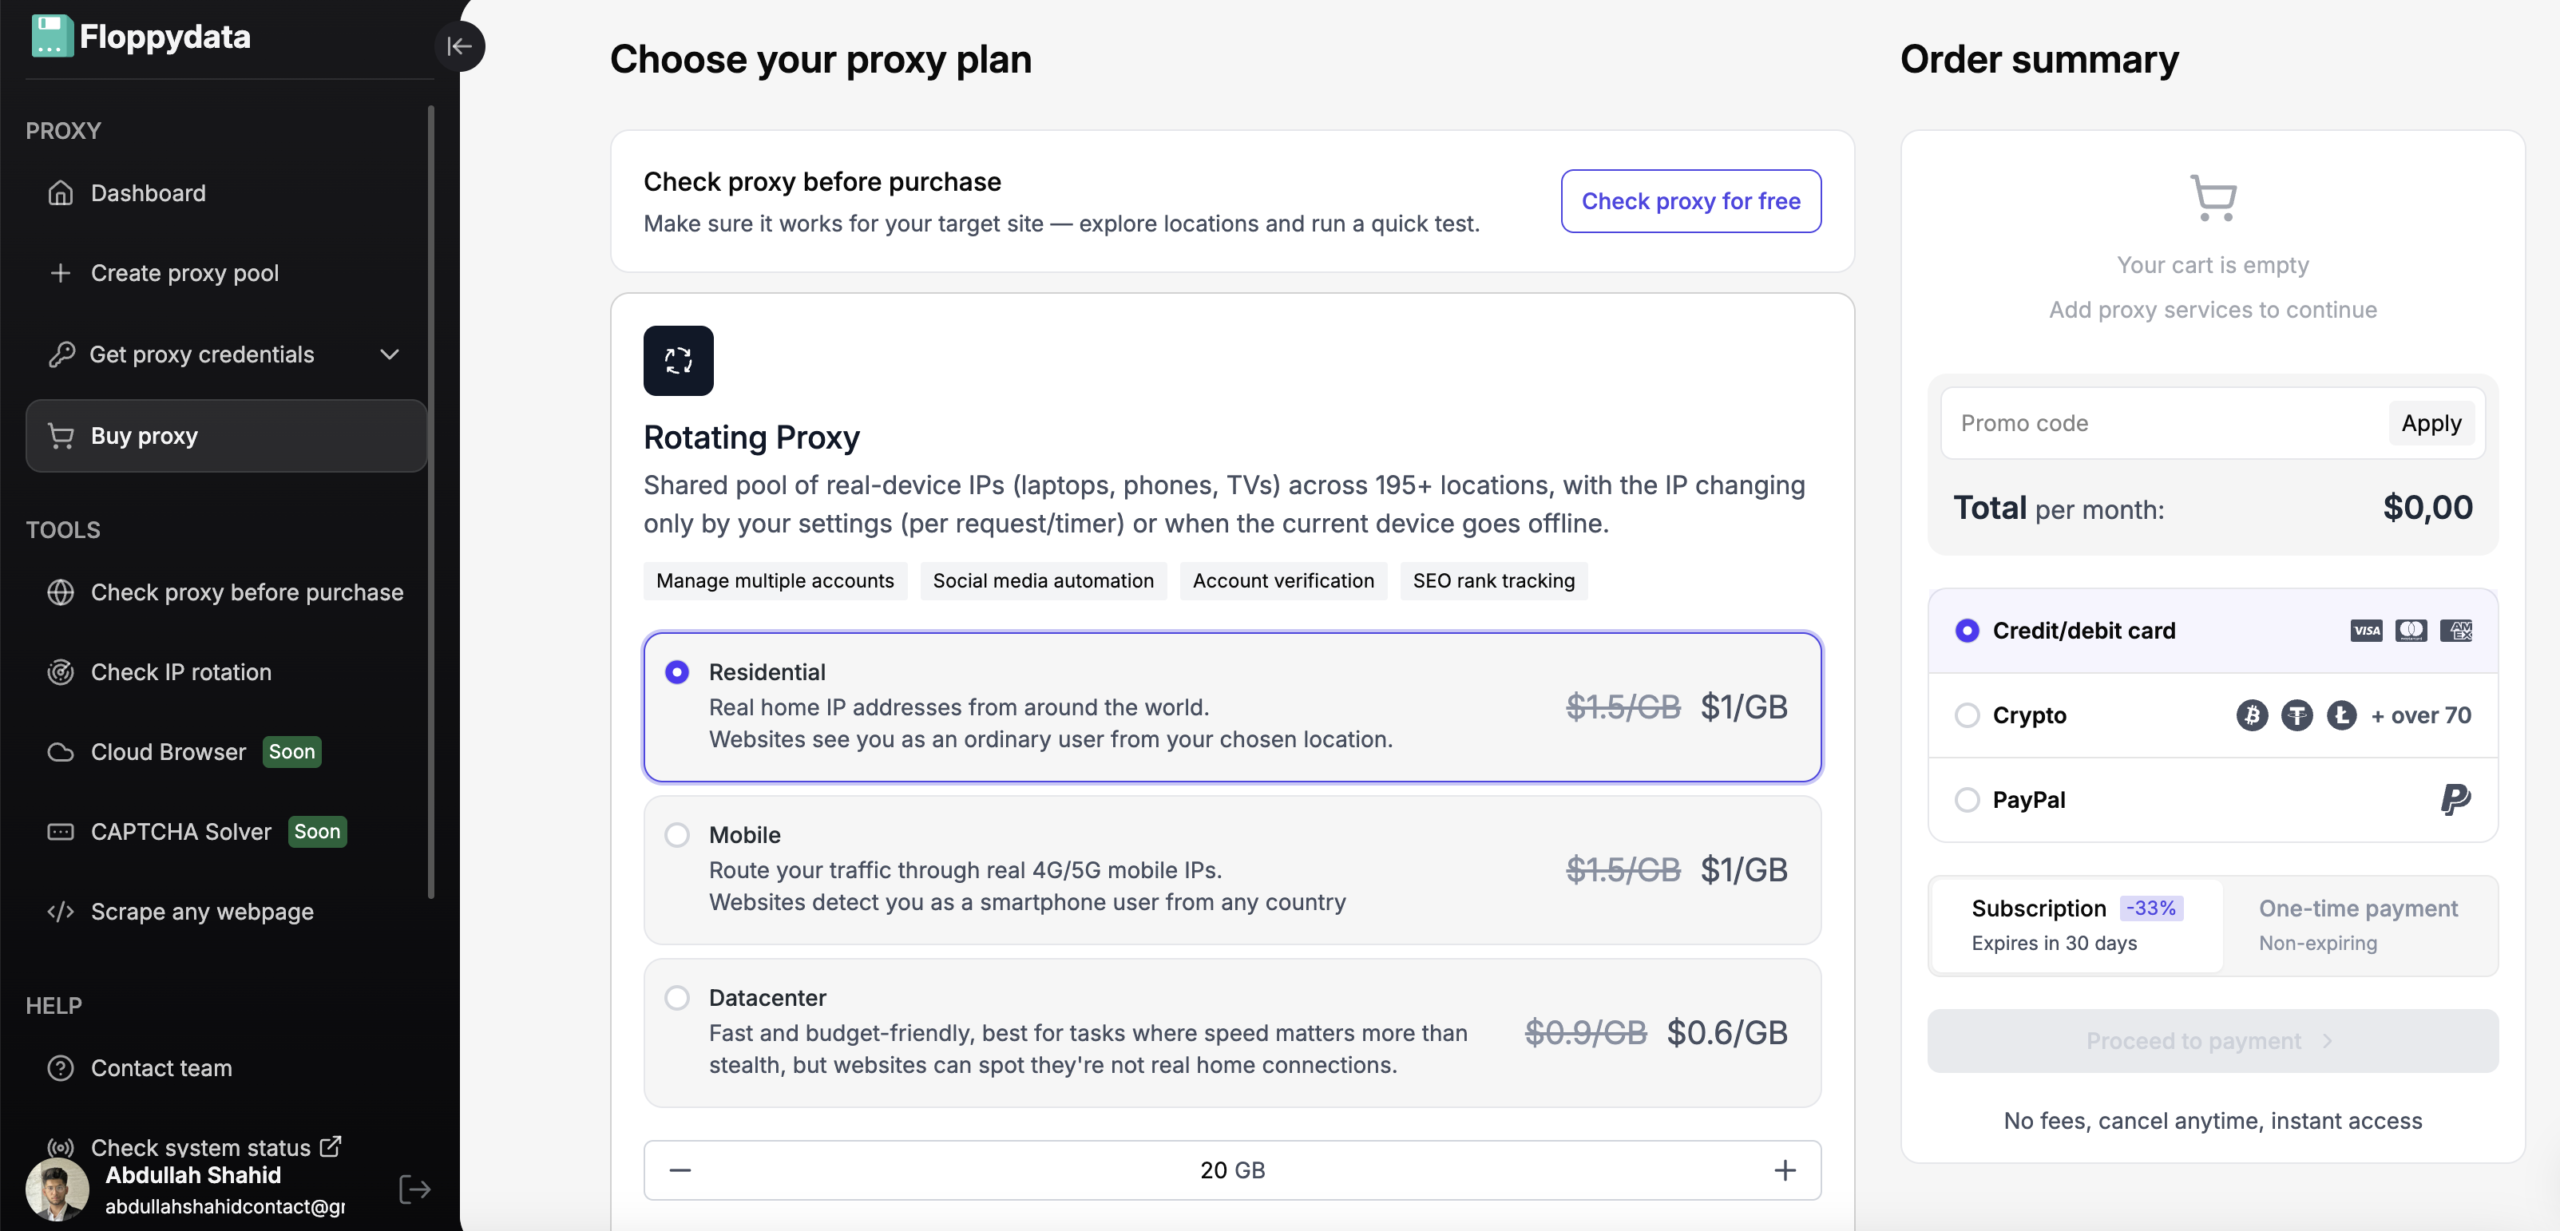
Крок #3: Проаналізуйте цільову URL-адресу
Вставте вашу URL-адресу в показане поле і натисніть “Проаналізувати”. Ви отримаєте HTML-вміст цієї сторінки разом із фрагментом коду, який можна додати до автоматизації вашого браузера. Якщо ви створюєте автоматизацію для отримання цін на товари з веб-сайту, ви можете використовувати розблокувальник веб-сайтів, щоб проаналізувати, який тег відображає веб-сайт. Потім я напишу свій скрипт автоматизації для вилучення наступних тегів і збереження їх у файлі excel/csv.
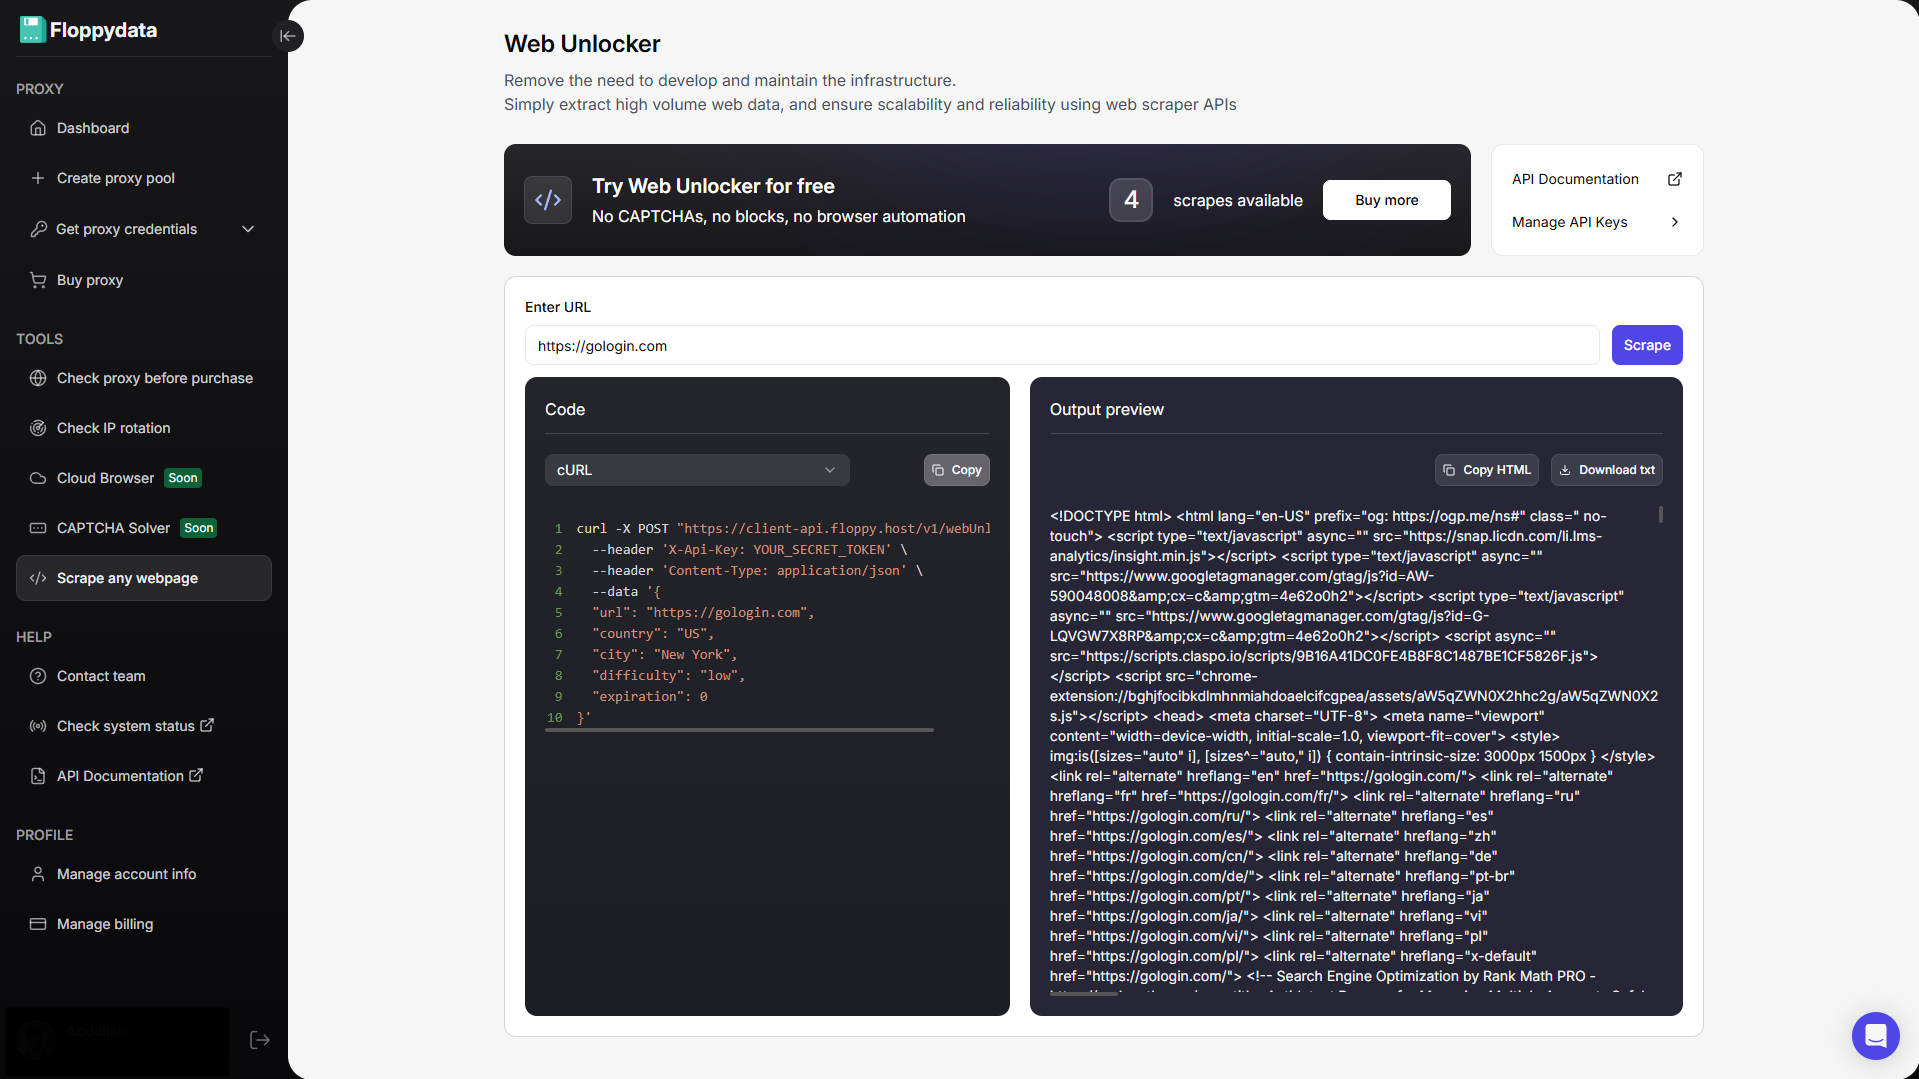
Крок #4: Створіть ключі API для автоматизації
Ви можете створити ключі API в налаштуваннях свого облікового запису. Ці API-ключі використовуватимуться у вашому скрипті автоматизації браузера, щоб ротувати проксі, завантажувати сторінки та скрапити дані. Floppydata Web Unlocker збирає дані і надсилає їх вашому скрипту через цей API.
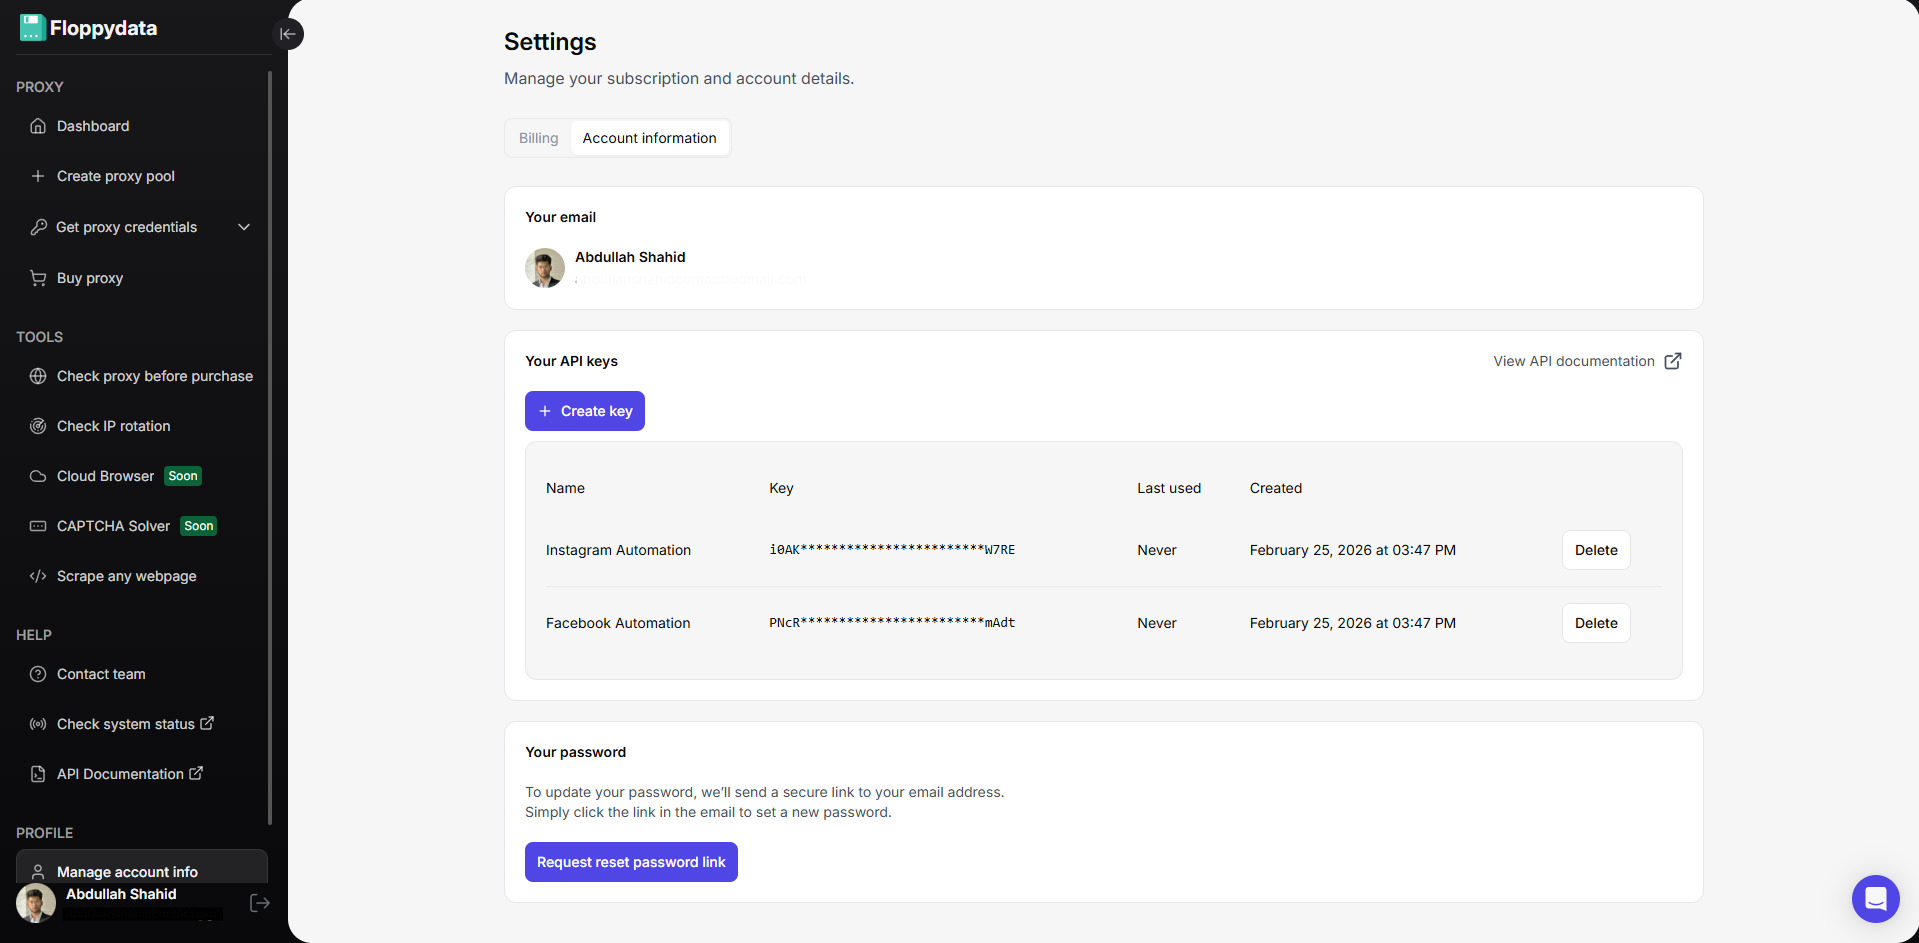
Крок #5: Напишіть і запустіть автоматизацію веб-скрепінгу
Тепер, коли у вас є ключ API і проксі, ви можете створити скрипт веб-скрепінгу на Python, Javascript, C# або GO. Помістіть ваш ключ API у фрагмент коду, показаний на сторінці веб-розблокувальника, разом з URL-адресами. Ви також можете додати до свого скрипта додаткові функції, наприклад, пошук певних тегів у вилучених даних з API, і зберегти їх у csv або excel-файл на своєму пристрої.
Ось як виглядає типовий фрагмент Python:
httpx.post(
“https://client-api.floppy.host/v1/webUnlocker”,
headers={
“Content-Type”: “application/json”,
“X-Api-Key”: “ВАШ_СЕКРЕТНИЙ_ТОКЕН”
},
json={{}}.
“url”: “http://ip-api.com/json”,
“країна”: “США”,
“місто”: “Нью-Йорк”,
“складність”: “низька”,
“закінчення терміну дії”: 0
}
)
Висновок
Замість того, щоб завантажувати кілька браузерів і налаштовувати проксі-сервери в кожному профілі, ви можете виконати всі автоматизовані операції за допомогою ключа API від Floppydata. Ви також можете поєднати цей API-ключ з антидетект-браузером на кшталт Gologin, який зберігає кожен проєкт в окремому профілі браузера.
Щасливого вишкрібання!