Table des matières
- Comparaison : Web Unblocker vs Web Proxy
- Cas d’utilisation des débloqueurs de sites web
- Pourquoi les sites web bloquent-ils l’extraction de données ?
- Comment les sites web repèrent les automatisations de scraping
- Guide : Comment utiliser Floppydata Web Unlocker pour l’automatisation du Web Scraping
- Conclusion
Un débloqueur web (ou Web Unlocker) est un outil en ligne qui charge pour vous des pages web publiques : il génère le rendu du JavaScript, relance les requêtes échouées et utilise des IP situées dans le pays dont vous avez besoin. Un débloqueur web est une version beaucoup plus avancée d’un proxy web. Au lieu de simplement réacheminer les requêtes d’URL via une autre adresse IP, les débloqueurs web chargent aussi la page complète et renvoient son HTML et ses données JSON.
Les utilisateurs ont généralement recours à des débloqueurs de sites web pour automatiser le scraping de données. Ce blog explore les débloqueurs de sites web en détail, en quoi ils diffèrent des proxies, quels sont les cas d’utilisation qu’ils servent et comment mettre en place une automatisation de scraping web à l’aide d’une API de déblocage de sites web fiable. Plongeons dans l’aventure !
Comparaison : Web Unblocker vs Web Proxy
Un site de proxy web classique vous permet d’accéder à un site web depuis une autre IP en réacheminant votre trafic via une IP différente, et c’est tout. Les proxys web sont aussi généralement plus lents, car la même IP et le même serveur sont partagés par des centaines, voire des milliers d’utilisateurs simultanés qui envoient de multiples requêtes. Les versions Premium des proxys web sont plus rapides, mais peuvent tout de même être partagées entre plusieurs utilisateurs Premium.
Un débloqueur de sites web ne se contente pas de changer d’adresse IP. Il charge la page dans un vrai navigateur, attend le JavaScript et le contenu chargé en différé, et relance la requête depuis une autre IP en cas d’échec.
Si vous utilisez un débloqueur web avancé comme le Web Unlocker de Floppydata, vous pouvez aussi scraper des données utiles sur des pages publiques, comme les fiches produits, les prix et les résultats de recherche sur eBay, Amazon et d’autres sites. Ces données scrappées sont ensuite nettoyées et utilisées pour l’entraînement de modèles d’IA, la création d’outils pour des plateformes spécifiques et d’autres cas d’utilisation valables.
Cas d’utilisation des débloqueurs de sites web
L’utilisation d’un débloqueur de sites web n’est pas illégale. La légalité dépend de ce que vous avez l’intention de faire avec les débrideurs de sites web. Si vous collectez des données publiques, que vous respectez les conditions de chaque site et son fichier robots.txt, et que vous laissez de côté les données personnelles, vous êtes dans les clous. Voici quelques cas d’utilisation courants des débrideurs de sites web.
1. Automatisation de l’extraction du Web à grande échelle
Le principal cas d’utilisation des déverrouilleurs de sites web est l’automatisation du web scraping. Vous ne vous contentez pas de scraper une URL, vous créez une automatisation complète qui parcourt des URL ou des domaines configurés de manière autonome, qui scrape les données de toutes les pages et qui les filtre pour vous fournir les données dont vous avez besoin.
Lorsque vous récupérez les données d’un site web, vous obtenez un code HTML de la page web. Ce code comprend tout le contenu de la page et sa mise en page. Vous pouvez ensuite extraire des informations utiles à partir de champs spécifiques. Le web scraping est utilisé pour alimenter les outils de suivi des prix des produits, le suivi des SERP pour le référencement, les annonces immobilières, les sites d’offres d’emploi et les études de marché.
2. Tests QA et surveillance
Si vous souhaitez tester le système anti-bot de votre site web, ou vérifier s’il fonctionne dans différentes régions et quel est le temps de latence, les débrideurs de sites web sont un excellent outil. Dans ce cas, vous n’accédez pas exactement à un site web bloqué, mais vous pouvez utiliser sa fonction d’automatisation pour effectuer des tests automatisés. Vous pouvez même spécifier vos propres adresses IP en sélectionnant des proxys de pays ou de villes spécifiques.
3. Collecte de données pour l’IA et l’analyse
Les modèles d’apprentissage automatique ont besoin de tonnes de données pour s’entraîner. Comme les entreprises préfèrent les données actualisées du web, elles utilisent des débrideurs de sites web et leur support API pour racler les sites web, stocker le contenu de leurs pages, extraire des données utiles de ce fichier HTML ou JSON et les introduire dans leur modèle pour obtenir de meilleurs résultats.
Pourquoi les sites web bloquent-ils l’extraction de données ?
Si la récupération de données est légale, pourquoi les entreprises déploient-elles des mesures aussi strictes contre les récupérateurs de données ? Si vous essayez d’utiliser un script Python pour extraire des données d’une page web, votre adresse IP peut être bloquée. Vous ne pouvez plus accéder au site web à partir de votre appareil. Il y a plusieurs raisons pour lesquelles les entreprises agissent de la sorte, notamment la surcharge des serveurs et la protection de la vie privée des utilisateurs.
Les entreprises n’aiment pas les racleurs de données et les débrideurs de sites web, car ils imposent une charge inutile aux serveurs. Un système automatisé typique de récupération de données envoie des milliers de requêtes de pages simultanément pour récupérer d’énormes quantités de données. Les entreprises doivent payer pour la charge que les racleurs de données imposent à leurs serveurs.
La protection de la propriété intellectuelle est une autre raison. Lorsqu’un site web investit du temps, des ressources et des efforts pour publier du contenu authentique, il ne veut pas que des scrapers de données le récupèrent facilement et l’utilisent sans autorisation. De la même manière, les réseaux sociaux protègent la vie privée de leurs utilisateurs.
Comment les sites web repèrent les automatisations de scraping
Un site web assure généralement le suivi des éléments suivants :
- Nombre de demandes par minute
- Adresse IP par laquelle les demandes sont effectuées
- Empreinte du navigateur de l’utilisateur (polices, webGL, système d’exploitation, fuseau horaire, etc.)
Si le site web détecte une activité de spam, il bloque l’IP et l’empreinte digitale du navigateur. Gardez une cadence de requêtes modérée, respectez le fichier robots.txt et les conditions du site, et utilisez une API officielle lorsque le site en propose une.
Ce que fait Floppydata Web Unlocker
Floppydata Web Unlocker utilise son propre pool d’adresses IP rotatives pour charger les pages à votre place. Au lieu d’utiliser l’IP de votre réseau, Floppydata s’appuie sur des proxys sécurisés et propres provenant de plus de 195 pays, ce qui vous permet de voir une page telle qu’elle s’affiche dans le pays ou la ville de votre choix.
Il génère le rendu du JavaScript et du contenu chargé en différé dans un vrai navigateur. Si une requête échoue, il applique automatiquement sa logique de nouvelle tentative et renvoie la même requête via un autre proxy.
Guide : Comment utiliser Floppydata Web Unlocker pour l’automatisation du Web Scraping
Si vous êtes un expert du scraper web, Floppydata Web Unlocker est le choix idéal. Il dispose de deux modes.
- Gratte-papier intégré à l’application pour un scrapping instantané de n’importe quelle URL
- Mode API pour l’exécution en masse d’automatismes de web scraping avec logique de réessai
Si vous souhaitez obtenir le contenu d’une seule page web, vous pouvez utiliser le débloqueur in-app de Floppydata. Cette méthode est généralement utilisée pour obtenir le contenu HTML d’un site web afin d’analyser la manière dont il affiche les informations.
Étape 1 : Créer un compte Floppydata
Inscrivez-vous sur Floppydata et ouvrez le tableau de bord. C’est là que vous pouvez gérer vos proxies et des outils comme le débloqueur de sites web.
Étape 2 : Créer un pool de serveurs mandataires
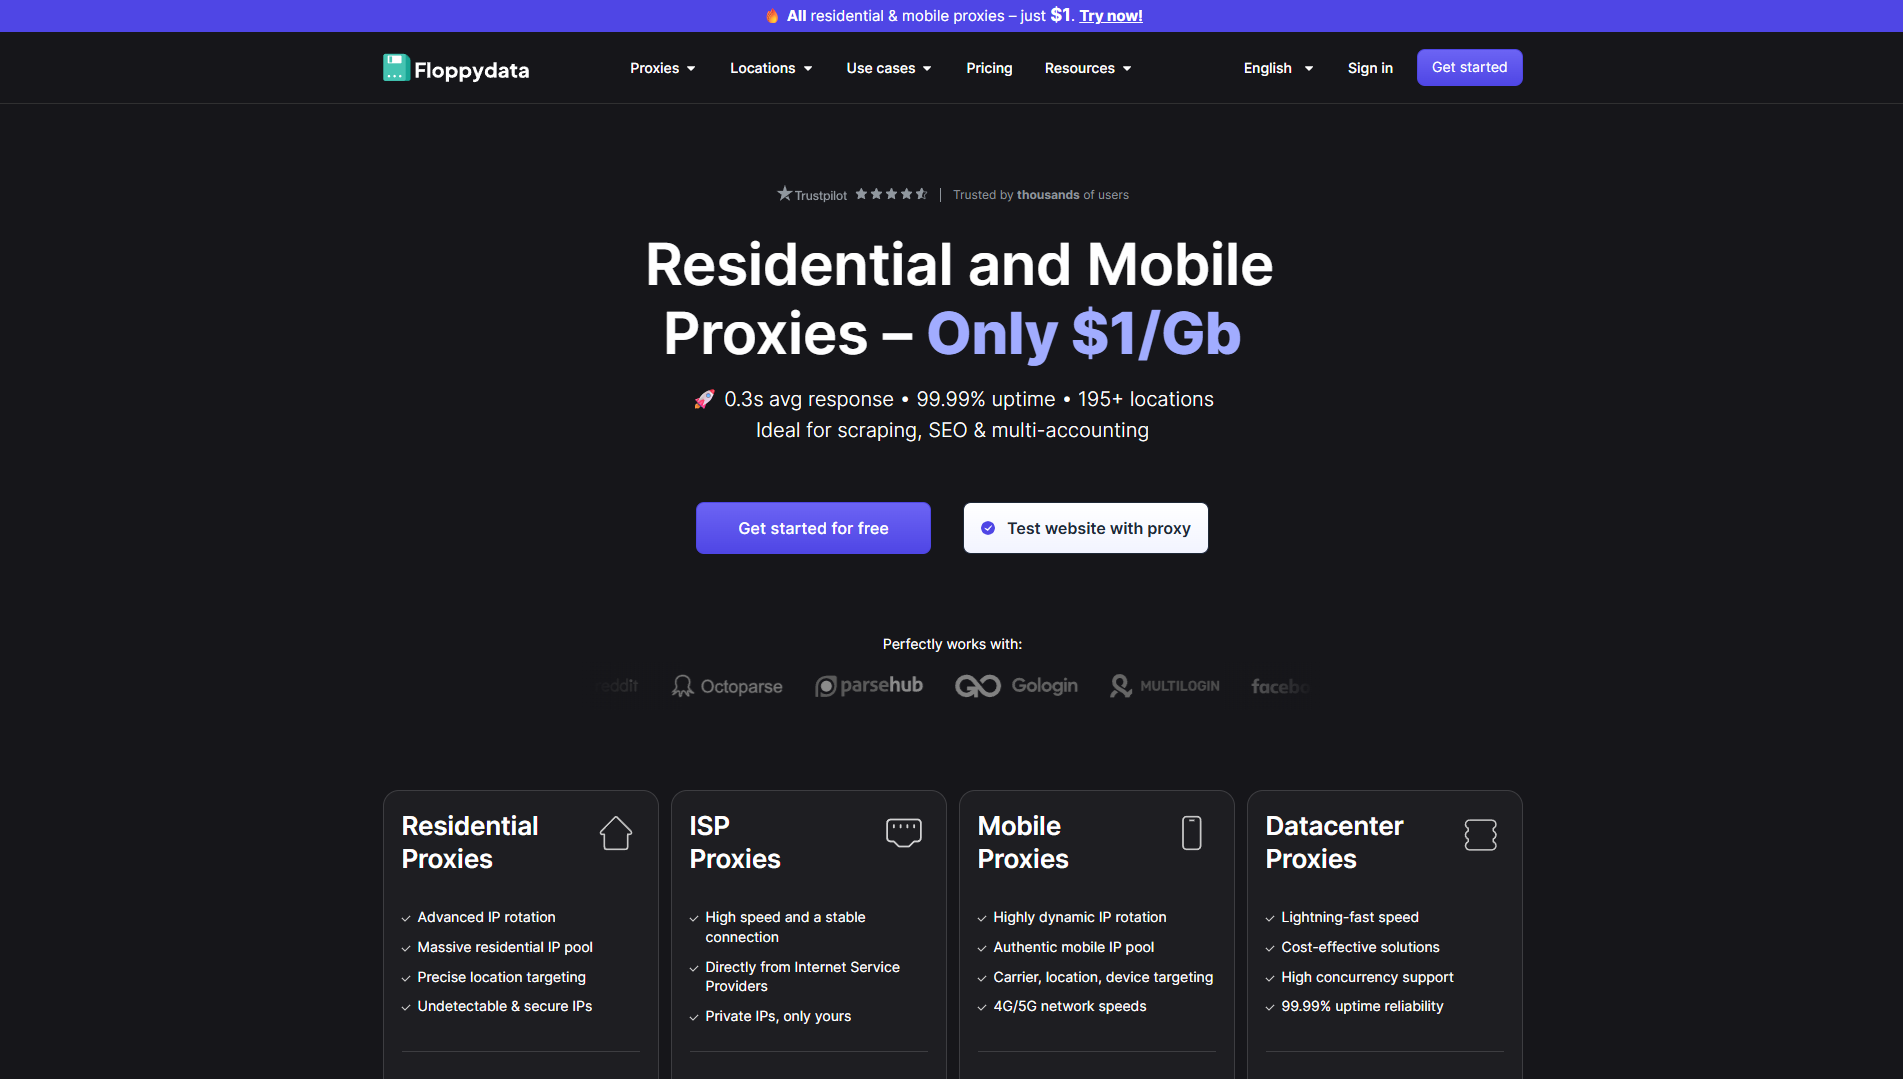
Vous pouvez acheter des proxys de plus de 195 pays et créer un pool de proxys à utiliser. Vous pouvez soit acheter des IP statiques, soit prendre de la bande passante pour des IP rotatives, qui seront remplacées automatiquement à chaque requête.
Étape 3 : Analyser l’URL cible
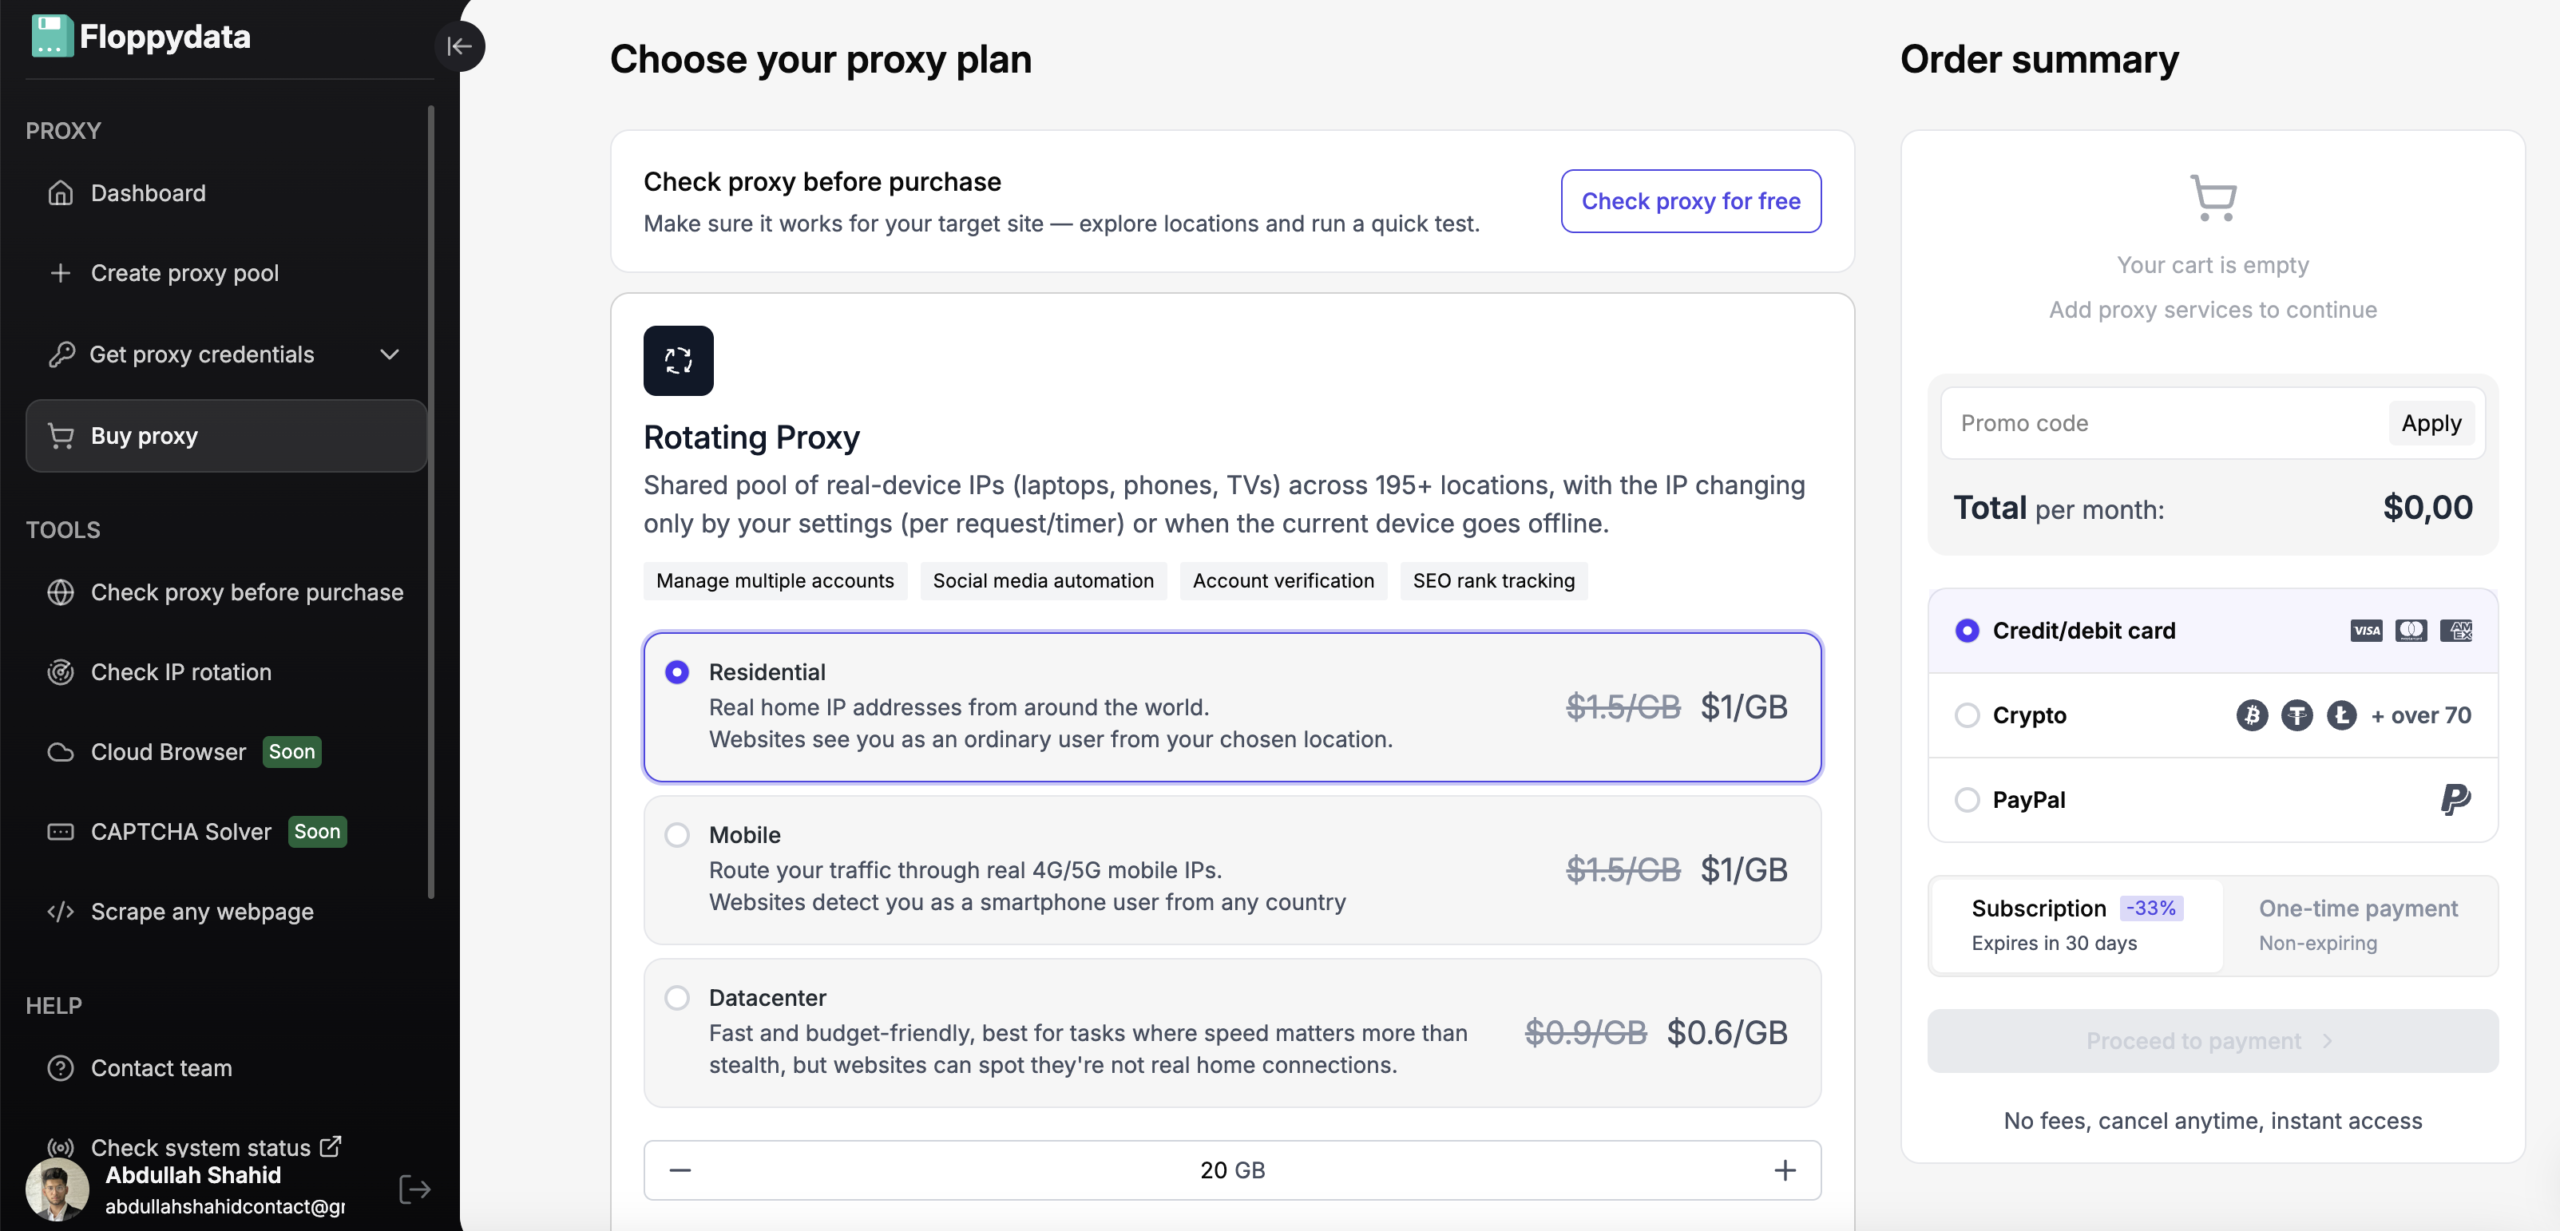
Collez votre URL dans le champ affiché et cliquez sur analyser. Vous obtiendrez le contenu HTML de cette page ainsi qu’un extrait de code à ajouter à l’automatisation de votre navigateur. Si vous créez un automatisme pour récupérer les prix des produits sur un site web, vous pouvez utiliser le déverrouilleur de site web pour analyser la balise qui affiche le site web. Je vais ensuite écrire mon script d’automatisation pour extraire spécifiquement les balises suivantes et les stocker dans mon fichier excel/csv.
Étape 4 : Créer des clés API pour l’automatisation
Vous pouvez créer des clés API à partir des paramètres de votre compte. Ces clés API seront utilisées dans votre script d’automatisation du navigateur pour faire tourner les proxys, charger les pages et scraper les données. Floppydata Web Unlocker récupère des données et les envoie à votre script via cette API.
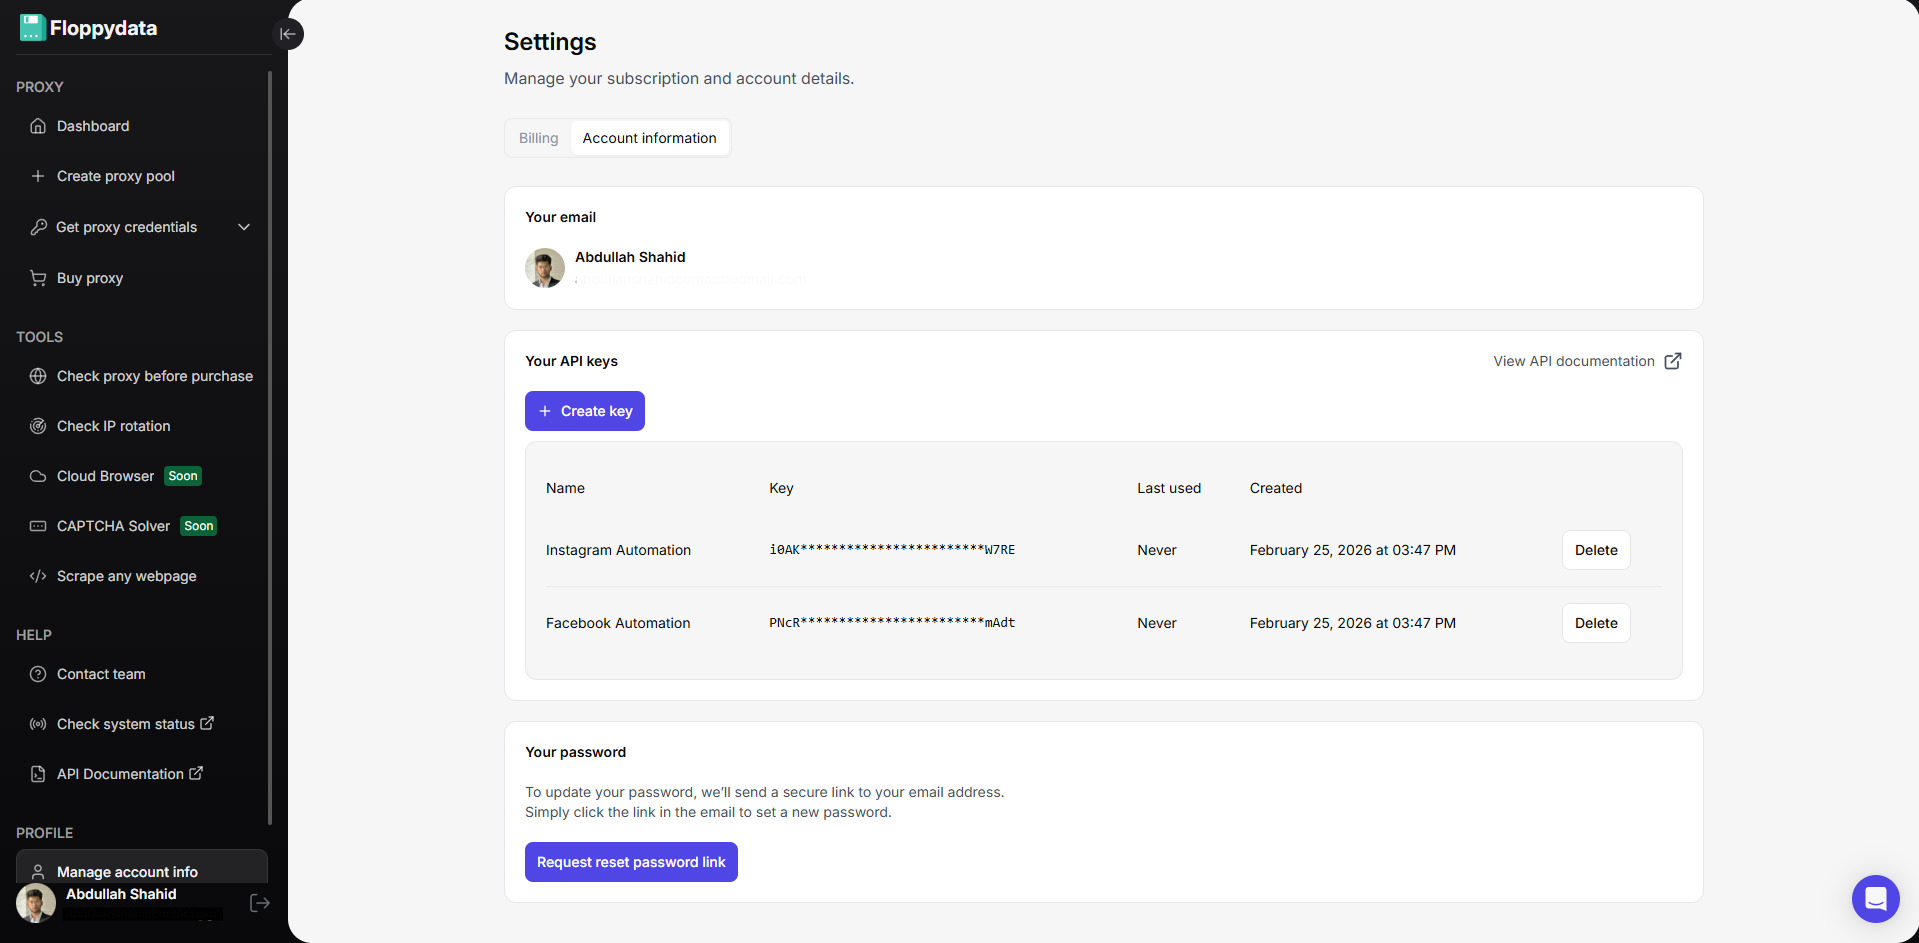
Étape 5 : Rédiger et exécuter l’automatisation de la recherche sur le Web
Maintenant que vous disposez de la clé API et des proxies, vous pouvez créer un script de web scraping en Python, Javascript, C# ou GO. Placez votre clé API dans l’extrait de code affiché sur la page de déverrouillage du web avec les URL. Vous pouvez également ajouter d’autres fonctionnalités à votre script, comme la recherche de balises spécifiques dans les données extraites de l’API, et les enregistrer dans un fichier csv ou excel sur votre appareil.
Voici à quoi ressemble un extrait typique de Python :
httpx.post(
« https://client-api.floppy.host/v1/webUnlocker »,
headers={
« Content-Type » : « application/json »,
« X-Api-Key » : « YOUR_SECRET_TOKEN »
},
json={
« url » : « http://ip-api.com/json »,
« country » : « US »,
« city » : « New York »,
« difficulté » : « faible »,
« expiration » : 0
}
)
Conclusion
Au lieu de télécharger plusieurs navigateurs et de configurer des proxys dans chaque profil, vous pouvez effectuer toutes vos automatisations de web scraping en utilisant la clé API de Floppydata. Vous pouvez aussi associer cette clé API à un navigateur anti-détection comme Gologin, qui garde chaque projet dans son propre profil de navigateur.
Bon grattage !