Índice
X (antes conocida como Twitter) es una de las principales plataformas de medios sociales. Con más de 500 millones de publicaciones (o tweets) al día, la plataforma alberga sin duda una gran cantidad de datos. Así que, si sabes cómo raspar datos de Twitter, tienes un lago de datos de análisis de tendencias, perspectivas competitivas y sentimiento de mercado.
Por lo tanto, puede utilizar fácilmente un raspador de Twitter para recopilar y transformar los tweets en información procesable. Aunque entender cómo raspar datos de Twitter tiene varias ventajas, el proceso puede resultar confuso debido a todas las restricciones.
¿No sabes por dónde empezar? Aquí te ofrecemos una guía completa sobre cómo scrapear tweets.
Empecemos.
¿Qué es el Twitter Data Scraping?
El scraping de Twitter es un proceso automatizado de extracción de datos públicos disponibles en la plataforma. Implica el uso de scrapers personalizados o de herramientas de scraping sin código. Twitter es una de las pocas plataformas que ofrece una API oficial, y es la vía que X admite para el acceso programático.
Algunos de los datos que puede recopilar de la plataforma son:
- Hilos de conversación: Citar tuits, respuestas, tuits compartidos, tuits marcados y cadenas de conversación conectadas a un tuit principal.
- Tweets: Contenido de texto, marca de tiempo, respuestas, retweets, me gusta y URL de medios.
- Métricas de compromiso: Me gusta, citas, retweets, recuento de favoritos.
¿Por qué Scrape X (antes Twitter)?
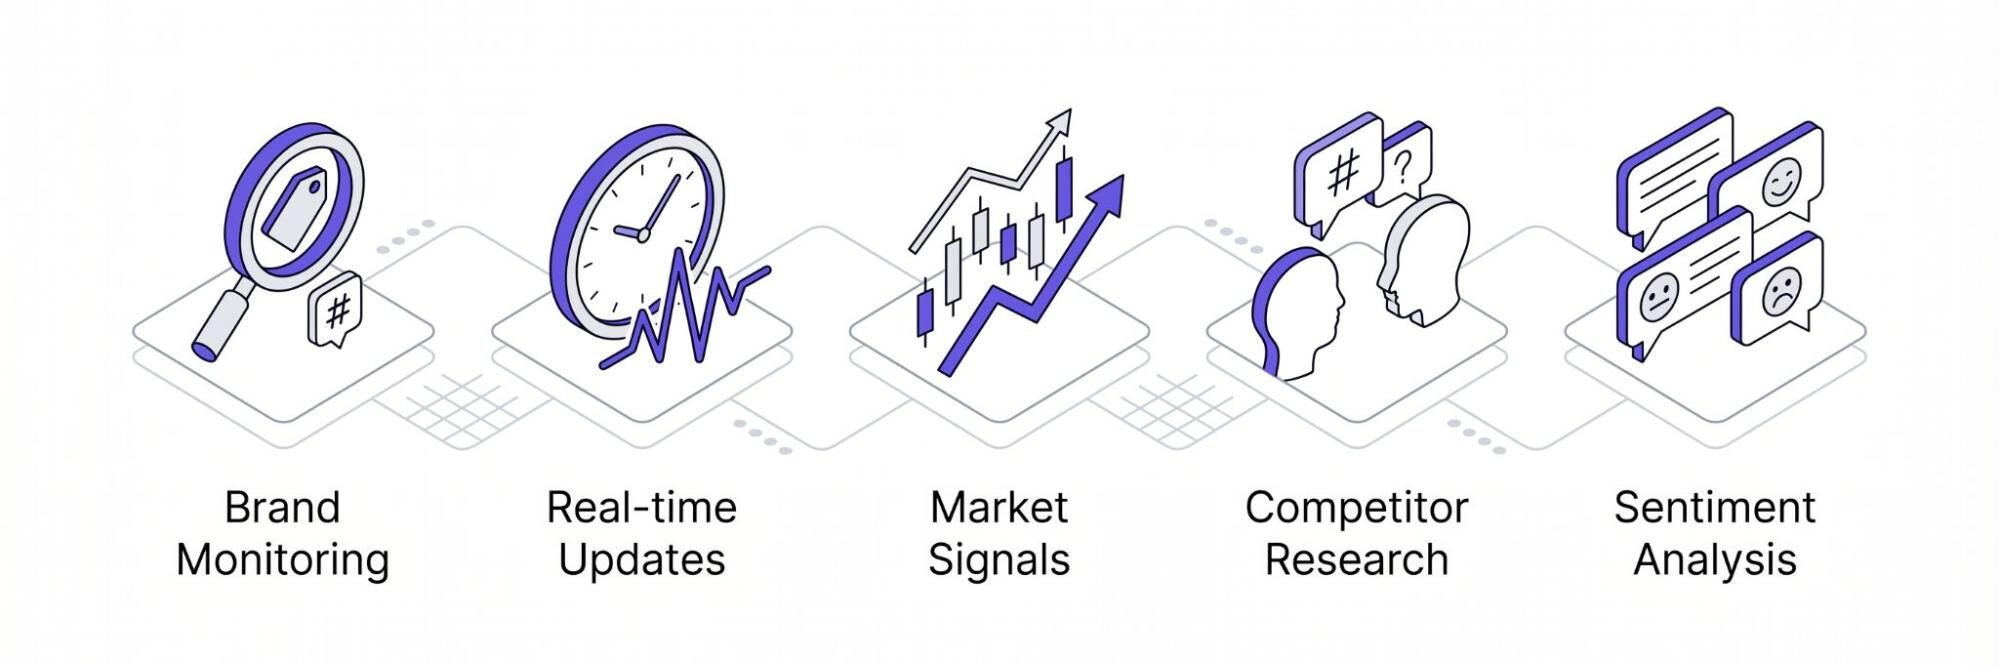
Estas son algunas de las razones más comunes por las que los particulares y las empresas necesitan un rascador de enlaces de Twitter para recopilar datos:
Supervisión de marcas
El scraping de Twitter es una buena forma de controlar lo que la gente dice de su marca en diferentes regiones. También ayuda a identificar la circulación de productos falsificados que pueden afectar negativamente a su marca. Por ejemplo, hay muchas quejas sobre la disminución de la calidad de los productos. Con estos datos, las marcas pueden tomar medidas para retirar todos los productos falsificados. También pueden cambiar sus envases para destacar aún más en las estanterías del mercado.
Actualizaciones en tiempo real
Aprender a scrapear tweets es una forma de obtener datos en tiempo real. Obtener actualizaciones en tiempo real es necesario para analizar la información inmediatamente cuando se producen. Por lo tanto, las empresas pueden tomar decisiones inmediatas basadas en datos y responder rápidamente a los cambios en las tendencias. Además, obtener actualizaciones en tiempo real es necesario para ofrecer experiencias personalizadas, como recomendaciones de productos en tiempo real.
Siga las señales del mercado
Twitter es una plataforma increíblemente útil para monitorizar y rastrear señales. Muchos anuncios en las comunidades financiera y de criptomonedas suelen surgir por primera vez en la plataforma. Por lo tanto, la recopilación de datos relevantes permite entender las tendencias, haciendo buenas predicciones sobre si el mercado experimentará un movimiento alcista o bajista.
Investigación de la competencia
Otra ventaja de recopilar datos de Twitter es que desempeña un papel clave en la investigación de la competencia. Proporciona información útil sobre lo que publican los competidores, los hashtags utilizados y cómo interactúan con su audiencia. Posteriormente, esto se puede analizar e integrar para
Análisis del sentimiento
Muchas personas acuden a Twitter para calificar o elogiar a las marcas en función de su percepción. Por lo tanto, la plataforma se convierte en una gran opción para recopilar datos para el análisis de sentimiento. Proporciona a las marcas información sobre cómo las percibe su audiencia y cómo pueden mejorar para mantenerse por delante de la competencia.
Cómo extraer datos de Twitter
En esta sección, exploraremos las mejores herramientas de Twitter scraper y cómo utilizarlas para extraer información de la plataforma
Uso de la API oficial de X
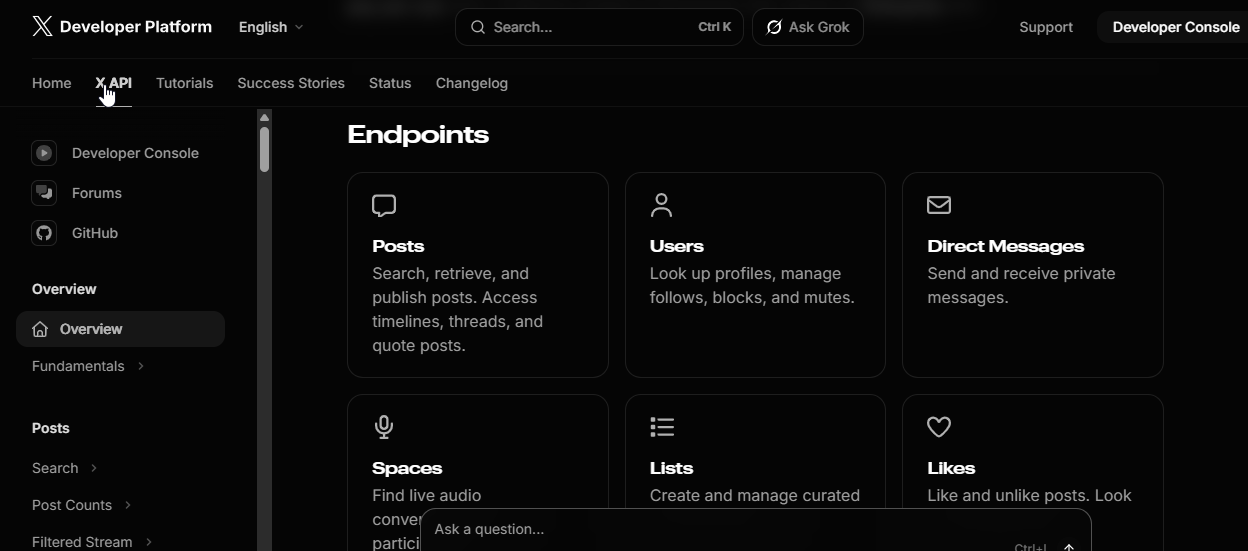
X cuenta con una API oficial diseñada para optimizar la obtención de datos. Aunque al principio era gratis, en 2023 pasó a ser una herramienta de pago. Sus niveles de acceso, precios y límites de solicitudes cambian con el tiempo, así que comprueba la documentación para desarrolladores de X para conocer las condiciones vigentes antes de empezar.
La API oficial es lo primero que debes comprobar: ofrece datos estructurados dentro de las normas de X. Para una página pública que la API no cubre, un scraper es la otra opción.
Construir un rascador
Lo primero que tienes que entender sobre la construcción de un scraper es que necesitas ser un programador experto o contratar a uno. Por el bien de esta guía, vamos a hacer referencia a Python y Selenium (un marco de automatización) para construir un raspador de Twitter. Python es generalmente preferido sobre otros lenguajes de programación, ya que es más simple, ofrece amplias herramientas de web scraping, y tiene una buena documentación.
He aquí un breve método para conseguirlo:
Establecer los requisitos previos
Crea un nuevo directorio para guardar los archivos del proyecto y crea un nuevo archivo Python para el código que estás escribiendo:
$ mkdir scrape_twitter
$ cd scrape_twitter
$ touch app.py
También necesita instalar Selenium y WebDrive Manager con este comando:
$ pip install selenium webdriver-manager
Buscar una página
Vamos a intentar obtener una página pública de Twitter para asegurarnos de que todo funciona bien. En el archivo que creamos anteriormente, añade los siguientes códigos:
from Selenium import webdriver
from selenium.webdriver.chrome.service import Servicio
from webdriver_manager.chrome import ChromeDriverManager
driver = webdriver.Chrome(service=Service(ChromeDriverManager().install()))
driver.get("https://x.com/XDevelopers")
El código anterior debería abrir inmediatamente la página de Twitter solicitada. Comienza importando el webdriver, el Servicio y el ChromeDriverManager. Normalmente, se inicializaría el controlador web proporcionando una ruta ejecutable para el binario del controlador específico del navegador en uso:
browser = webdriver.Chrome(executable_path=r "C:|path\to\chromedriver.exe")
El binario necesita ser actualizado con cada actualización del navegador, y esto puede ser frustrante. Para solucionarlo, puedes añadir ChromeDriverManager().install(), que descarga automáticamente el binario necesario para el navegador
Nota: Puedes ampliar este código para recopilar publicaciones públicas sobre tu marca.
Ten en cuenta que las condiciones de X limitan el acceso automatizado y que gran parte del sitio solo es visible después de iniciar sesión. Limita tu scraper a las páginas públicas que puedas abrir sin una cuenta, respeta los límites de solicitudes y usa la API oficial cuando cubra tu necesidad.
Utilice un rascador sin código
Por último, en las mejores herramientas de Twitter scraper, tenemos la opción sin código. Como su nombre indica, no implica ningún tipo de codificación ni requiere conocimientos o experiencia con lenguajes de programación. Por lo tanto, son herramientas para principiantes que hacen posible que cualquiera pueda extraer datos de Twitter.
La mayoría de los raspadores sin código tienen una interfaz de apuntar y hacer clic, lo que los hace muy fáciles de usar. Ya están diseñados para interactuar con la API de la plataforma para una recuperación de datos eficaz. A diferencia de los scrapers DIY que requieren un mantenimiento constante, los scrapers sin código eliminan este reto ya que el proveedor es responsable de sus funciones.
Estos raspadores sin código están ganando cada vez más popularidad por varias razones. Aparte de su facilidad de uso, proporcionan una vía de accesibilidad que puede ser aprovechada por cualquiera, independientemente de su experiencia técnica. Por tanto, las empresas no tienen que invertir recursos en crear un scraper, mantenerlo y seguir el ritmo de cada cambio del sitio.
Los scrapers sin código suelen incluir herramientas integradas como gestión de proxies, reintentos, renderizado de JavaScript y más para garantizar una obtención eficaz de datos de Twitter. Sin embargo, el rendimiento y la calidad de los datos extraídos varían en función del proveedor de servicios. Factores como el coste, el rendimiento, la documentación y la atención al cliente deben tenerse muy en cuenta antes de elegir la mejor solución no-scrape.
¿Dónde conseguir un Twitter Scraper?
Floppydata destaca, no sólo como un servicio proxy fiable para gestionar múltiples cuentas de Twitter, sino también como scraper. Su solución de extracción de datos sin código incluye funciones sólidas que hacen que recopilar publicaciones públicas sea una experiencia positiva.
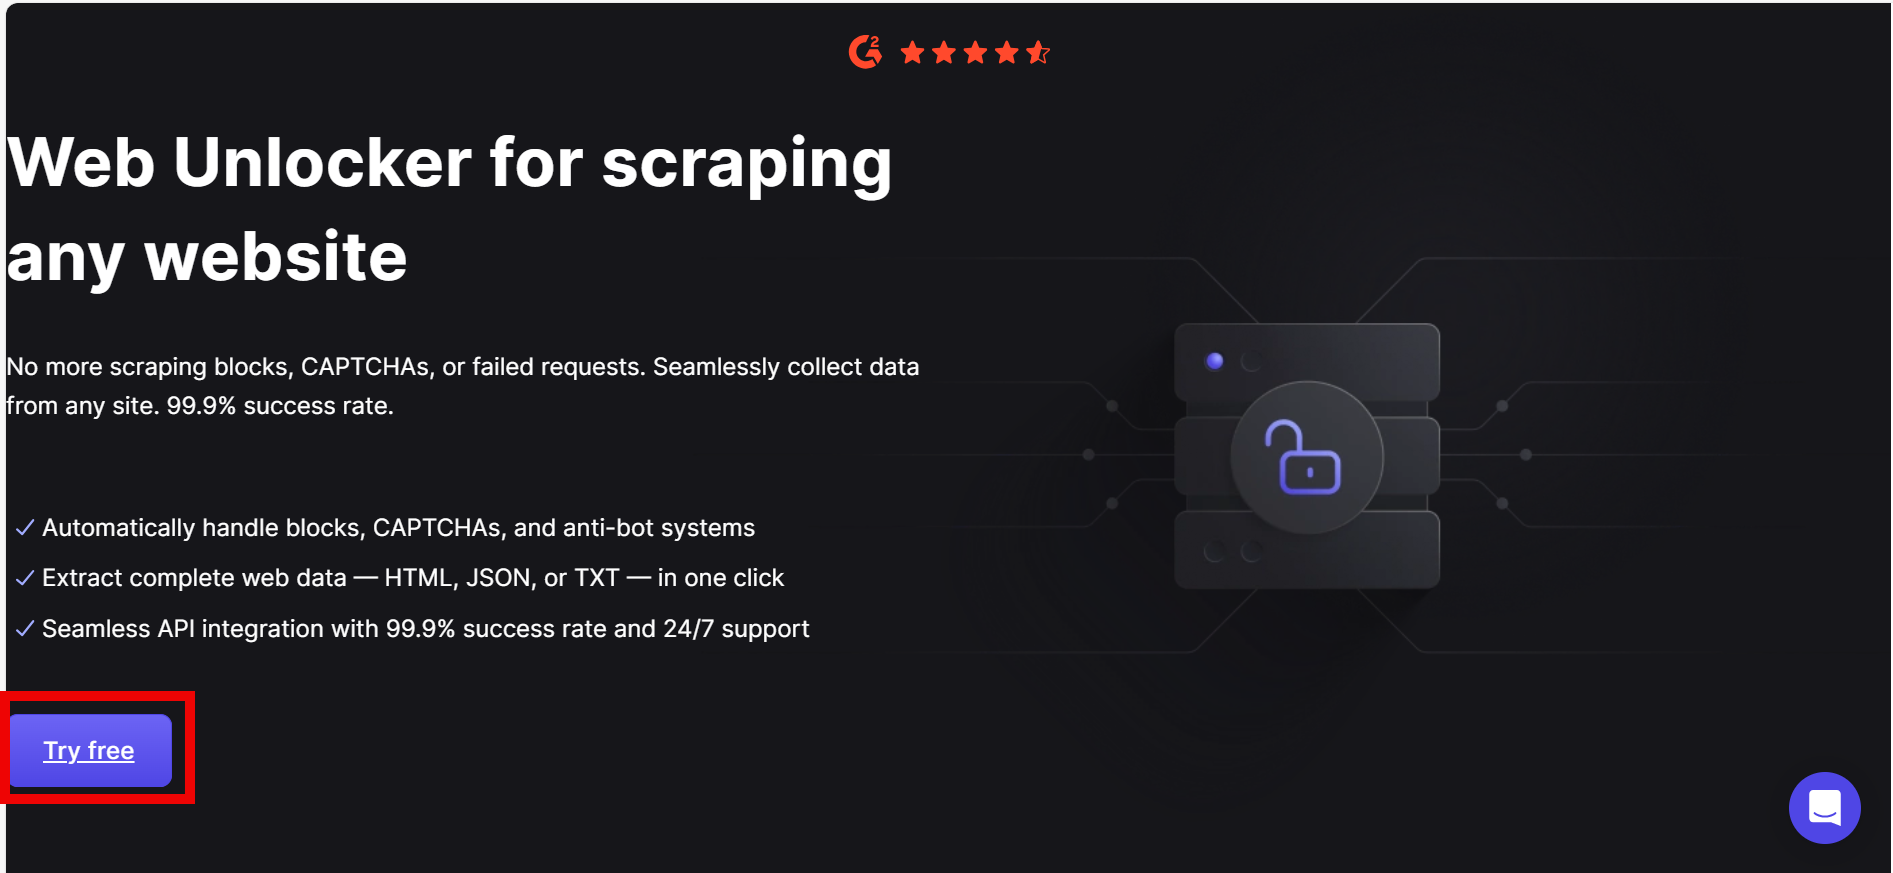
La herramienta de raspado Web Unblocker de Floppydata le permite conectarse con la plataforma, extraer los datos necesarios y guardarlos en un formato fácil de usar. Estas son algunas de sus características:
- Renderiza la infraestructura JavaScript de la plataforma para extraer datos completos
- Rotación automática de proxies integrada para solicitudes fiables.
- Lógica de reintentos inteligente, para que no tengas que reintentar manualmente
Otro factor que convierte a Floppydata en la mejor opción son los niveles de precios. Además, los frecuentes costes de mantenimiento de los scrapers DIY pueden suponer rápidamente unos costes elevados que no resultan prácticos para las pequeñas empresas.
Por otro lado, Floppydata garantiza la accesibilidad asegurándose de que incluso las personas que necesitan raspar datos de Twitter puedan permitírselo. Es más, ofrecen 5 raspados gratuitos para nuevos usuarios, lo cual es un gran comienzo para tu proyecto de extracción de datos. Desde tan sólo 0,98 $ por 1.000 resultados, puedes conseguir la herramienta. Si tienes necesidades personalizadas, puedes ponerte en contacto con el equipo para obtener un esquema de precios personalizado.
Cómo raspar datos de Twitter con Floppydata Web Unblocker
Extraer datos de Twitter con el Desbloqueador Web de Floppydata es sencillo y sólo requiere unos pocos pasos. Aquí tienes una guía sencilla para extraer datos de Twitter:
Paso 1: Visita la página de Web Unblocker e inicia sesión para empezar
Paso 2: Copia la dirección de la página pública que necesites, por ejemplo el perfil de tu marca o una publicación pública.
Paso 3: Ve al panel de Floppydata’s Web Unblocker y pega la URL
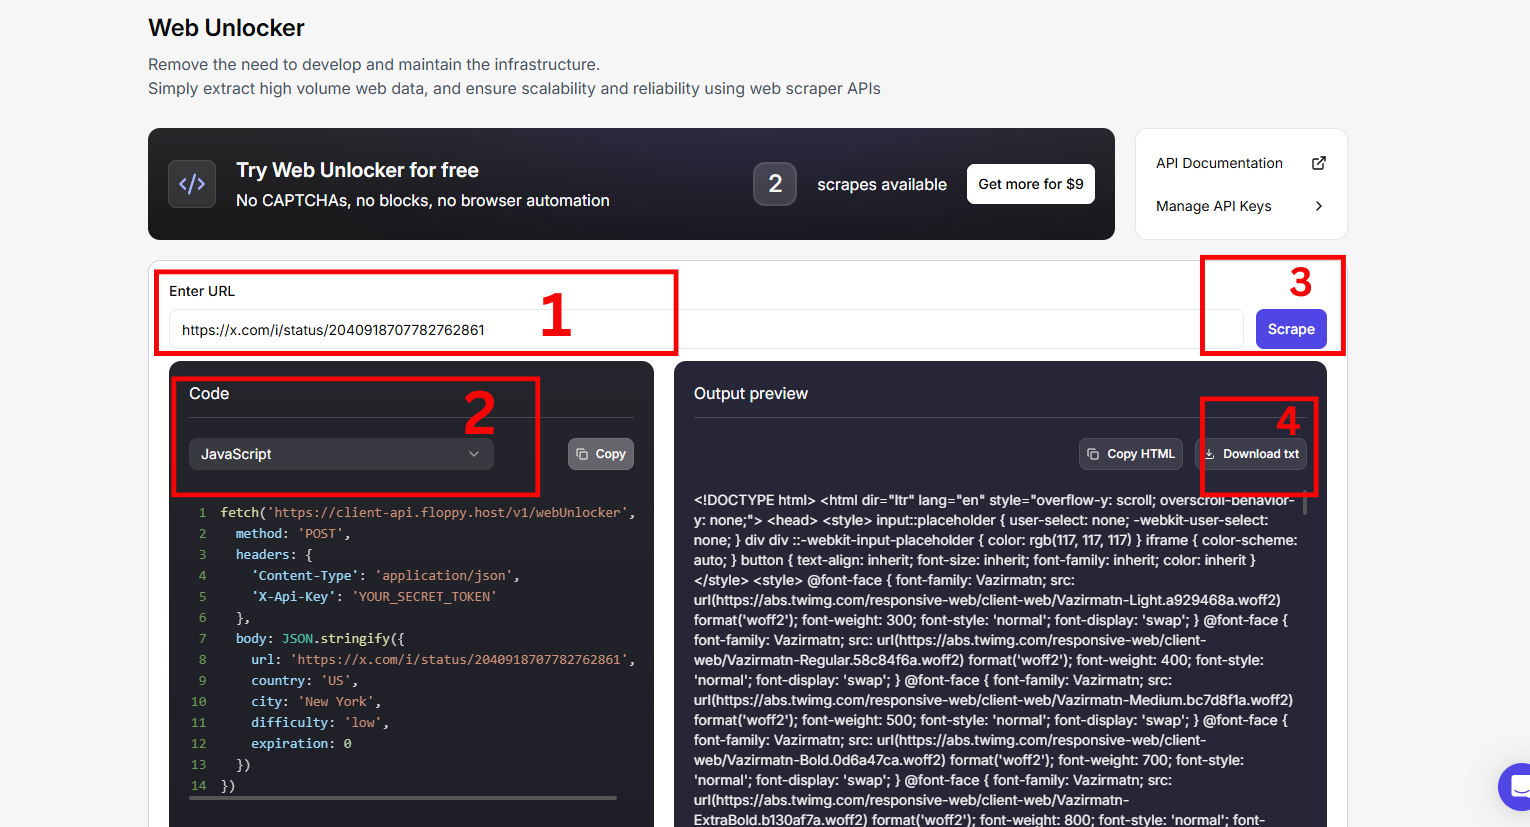
Paso 4: Los resultados estarán listos en unos minutos.
Y habrás extraído datos de Twitter con éxito y sin estrés.
Conclusión
Aprender a raspar datos de Twitter es bastante sencillo. Sin embargo, como se menciona en esta guía, X limita el acceso automatizado y cambia su sitio con frecuencia, por lo que un scraper propio requiere un mantenimiento constante.
Floppydata te quita de encima este mantenimiento: renderiza las páginas en un navegador real, rota las IP y reintenta las solicitudes fallidas, para que puedas centrarte en las publicaciones públicas sobre tu marca y tu mercado.