Table des matières
X (anciennement connu sous le nom de Twitter) est l’une des principales plateformes de médias sociaux. Avec plus de 500 millions de messages (ou tweets) par jour, la plateforme contient sans aucun doute une grande quantité de données. Ainsi, si vous savez comment récupérer les données de Twitter, vous disposez d’un lac de données pour l’analyse des tendances, la connaissance de la concurrence et le sentiment du marché.
Par conséquent, vous pouvez facilement utiliser un scraper Twitter pour collecter et transformer les tweets en informations exploitables. Bien qu’il y ait plusieurs avantages à comprendre comment extraire des données de Twitter, le processus peut être déroutant en raison de toutes les restrictions.
Vous ne savez pas par où commencer ? Nous sommes là pour vous fournir un guide complet sur la façon de récupérer des tweets.
Commençons !
Qu’est-ce que l’extraction de données sur Twitter ?
Le scraping Twitter est un processus automatisé d’extraction de données accessibles au public sur la plateforme. Elle repose sur des scrapers sur mesure ou des outils de scraping no-code. Twitter est l’une des rares plateformes à proposer une API officielle, et c’est la voie que X prend en charge pour l’accès programmatique.
Voici quelques-unes des données que vous pouvez collecter à partir de la plateforme :
- Fils de discussion : Citation de tweets, réponses, tweets partagés, tweets mis en signet et chaînes de conversation liées à un tweet parent.
- Tweets: Contenu du texte, horodatage, réponses, retweets, likes et URL des médias.
- Mesures d’engagement: Appréciations, citations, retweets, nombre de signets.
Pourquoi Scrape X (anciennement Twitter) ?
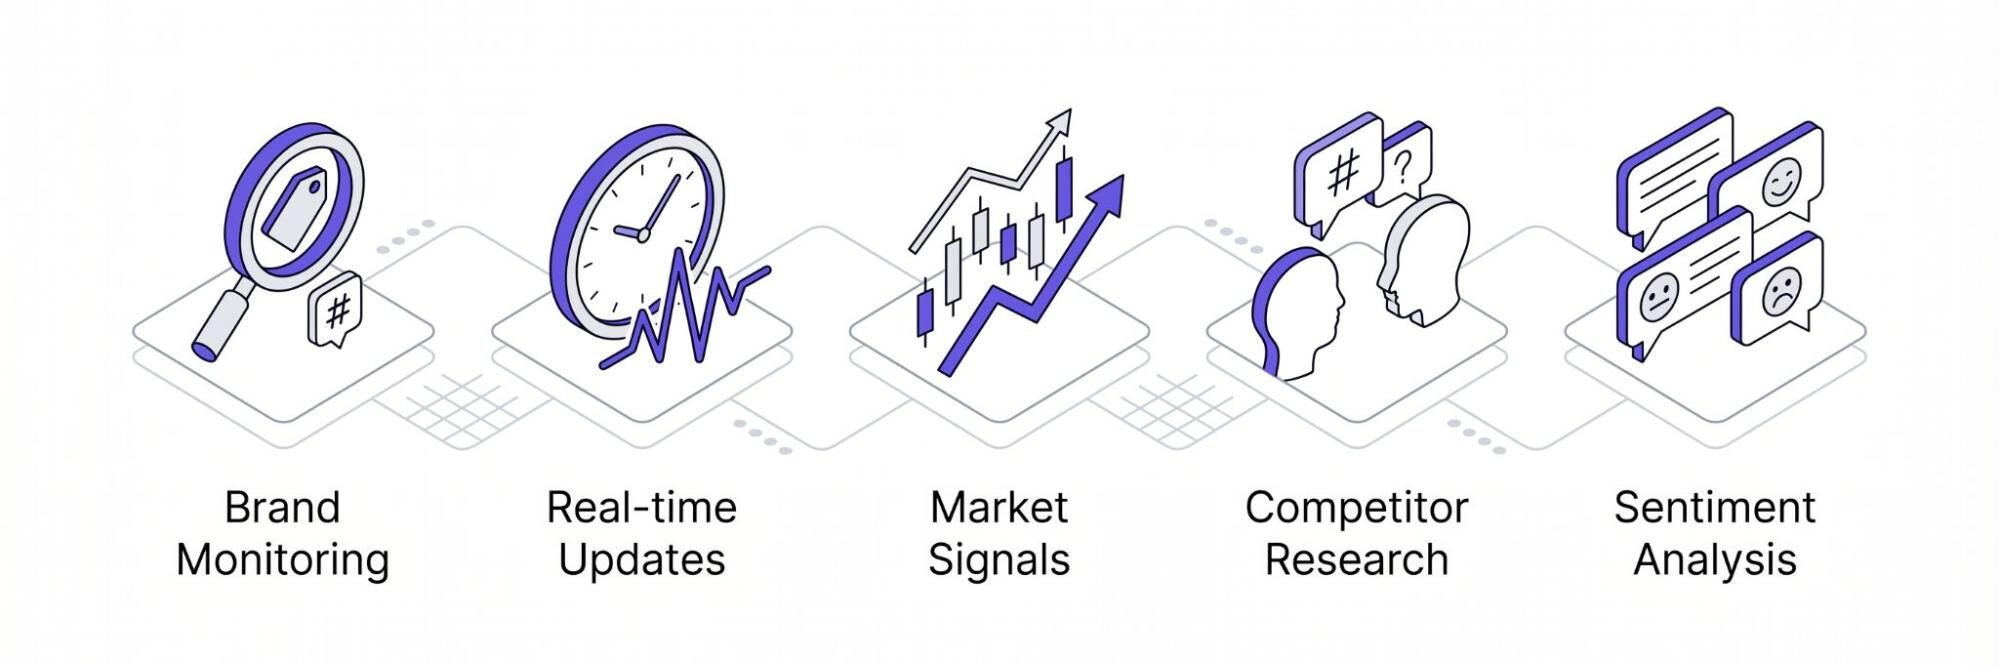
Voici quelques raisons courantes pour lesquelles les particuliers et les entreprises ont besoin d’un scraper de liens Twitter pour collecter des données :
Surveillance de la marque
Le scraping de Twitter est un bon moyen de surveiller ce que les gens disent de votre marque dans différentes régions. Il permet également d’identifier la circulation de produits contrefaits susceptibles d’avoir un impact négatif sur votre marque. Par exemple, il existe de nombreuses plaintes concernant la baisse de la qualité des produits. Grâce à ces données, les marques peuvent prendre des mesures pour retirer tous les produits contrefaits. Elles peuvent également modifier leur emballage pour se démarquer davantage sur les étagères du marché.
Mises à jour en temps réel
Apprendre à récupérer des tweets est un moyen d’obtenir des données en temps réel. Obtenir des mises à jour en temps réel est nécessaire pour analyser les informations dès qu’elles se produisent. Les entreprises peuvent ainsi prendre des décisions immédiates fondées sur des données et réagir rapidement aux changements de tendances. En outre, l’obtention de mises à jour en temps réel est nécessaire pour fournir des expériences personnalisées telles que des recommandations de produits en temps réel.
Suivre les signaux du marché
Twitter est une plateforme incroyablement utile pour surveiller et suivre les signaux. De nombreuses annonces dans les communautés de la finance et de la cryptographie apparaissent souvent pour la première fois sur la plateforme. Par conséquent, la collecte de données pertinentes vous permet de comprendre les tendances, de faire de bonnes prédictions sur la question de savoir si le marché connaîtra un mouvement haussier ou baissier.
Recherche de concurrents
Un autre avantage de la collecte de données sur Twitter est qu’elle joue un rôle clé dans la recherche de concurrents. Elles fournissent des informations utiles sur ce que les concurrents publient, sur les hashtags utilisés et sur la manière dont ils interagissent avec leur public. Ces informations peuvent ensuite être analysées et intégrées à des études de marché.
Analyse des sentiments
De nombreuses personnes se rendent sur Twitter pour critiquer ou faire l’éloge de marques en fonction de leur perception. Par conséquent, la plateforme devient une excellente option pour collecter des données pour l’analyse des sentiments. Elle permet aux marques de savoir comment leur public les perçoit et comment elles peuvent s’améliorer pour garder une longueur d’avance sur la concurrence.
Comment extraire des données de Twitter
Dans cette section, nous allons explorer les meilleurs outils de scraper de Twitter et la manière de les utiliser pour extraire des informations de la plateforme.
Utiliser l’API officielle de X
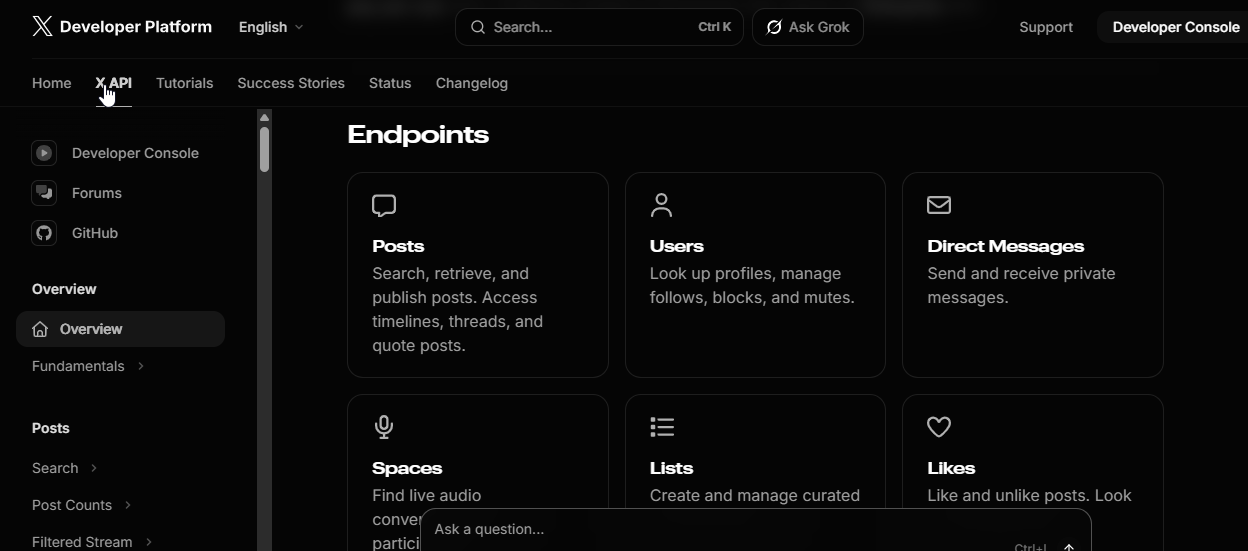
X dispose d’une API officielle conçue pour optimiser la récupération des données. Bien qu’elle ait d’abord été gratuite, elle est devenue un outil payant en 2023. Ses niveaux d’accès, ses tarifs et ses limites de débit évoluent avec le temps ; consultez donc la documentation développeur de X pour connaître les conditions actuelles avant de commencer.
L’API officielle est la première chose à vérifier : elle fournit des données structurées dans le respect des règles de X. Pour une page publique que l’API ne couvre pas, un scraper est l’autre option.
Construire un grattoir
La première chose que vous devez comprendre pour construire un scraper est que vous devez être un programmeur compétent ou en embaucher un. Pour les besoins de ce guide, nous ferons référence à Python et Selenium (un cadre d’automatisation) pour construire un scraper Twitter. Python est généralement préféré à d’autres langages de programmation parce qu’il est plus simple, qu’il offre de nombreux outils de scraping web et qu’il dispose d’une bonne documentation.
Voici une brève méthode pour y parvenir :
Mise en place des conditions préalables
Créez un nouveau répertoire pour enregistrer les fichiers du projet et créez un nouveau fichier Python pour le code que vous écrivez :
$ mkdir scrape_twitter
$ cd scrape_twitter
touch app.py
Vous devez également installer Selenium et WebDrive Manager avec cette commande :
pip install selenium webdriver-manager
Récupérer une page
Essayons de récupérer une page Twitter publique pour vérifier que tout fonctionne bien. Dans le fichier que nous avons créé ci-dessus, ajoutez les codes suivants :
from Selenium import webdriver
from selenium.webdriver.chrome.service import Service
from webdriver_manager.chrome import ChromeDriverManager
driver = webdriver.Chrome(service=Service(ChromeDriverManager().install()))
driver.get("https://x.com/XDevelopers")
Le code ci-dessus devrait ouvrir immédiatement la page Twitter demandée. Il commence par importer le pilote web, le Service et le ChromeDriverManager. Habituellement, il initialise le pilote web en fournissant un chemin d’accès à l’exécutable pour le binaire du pilote spécifique au navigateur utilisé :
browser = webdriver.Chrome(executable_path=r "C:\path\to\chromedriver.exe")
Le binaire doit être mis à jour à chaque mise à jour du navigateur, ce qui peut être frustrant. Pour résoudre ce problème, vous pouvez ajouter ChromeDriverManager().install(), qui télécharge automatiquement le binaire requis pour le navigateur.
N.B. : vous pouvez vous appuyer sur ce code pour collecter les publications publiques concernant votre marque.
Gardez à l’esprit que les conditions de X limitent l’accès automatisé et qu’une grande partie du site n’est visible qu’après connexion. Limitez votre scraper aux pages publiques que vous pouvez ouvrir sans compte, respectez les limites de débit et utilisez l’API officielle lorsqu’elle répond à votre besoin.
Utilisez un grattoir sans code
Enfin, parmi les meilleurs outils de scraper Twitter, nous avons l’option sans code. Comme son nom l’indique, elle n’implique aucun type de codage et ne nécessite aucune connaissance ou expérience des langages de programmation. Il s’agit donc d’outils conviviaux pour les débutants qui permettent à n’importe qui d’extraire des données de Twitter.
La plupart des scrapers sans code ont une interface de type « pointer et cliquer », ce qui les rend très faciles à utiliser. Ils sont déjà conçus pour interagir avec l’API de la plateforme pour une récupération efficace des données. Contrairement aux scrapers bricolés qui nécessitent une maintenance constante, les scrapers sans code éliminent ce défi car le fournisseur est responsable de ses fonctions.
Ces « scrapers » sans code sont de plus en plus populaires pour plusieurs raisons. Outre leur facilité d’utilisation, ils offrent une voie d’accès qui peut être exploitée par n’importe qui, quelle que soit son expérience technique. Les entreprises n’ont donc pas à consacrer des ressources à la création d’un scraper, à sa maintenance et au suivi de chaque modification du site.
Les scrapers no-code sont généralement dotés d’outils intégrés tels que la gestion des proxys, les nouvelles tentatives, le rendu JavaScript et bien plus, pour garantir une récupération efficace des données de Twitter. Toutefois, les performances et la qualité des données extraites varient en fonction du fournisseur de services. Des facteurs tels que le coût, la performance, la documentation et le support client doivent être soigneusement pris en compte avant de choisir la meilleure solution de « no-scrape ».
Où se procurer un Twitter Scraper ?
Floppydata se distingue non seulement en tant que service proxy fiable pour la gestion de plusieurs comptes Twitter, mais aussi en tant que scraper. Leur solution d’extraction de données no-code offre des fonctionnalités robustes qui font de la collecte de publications publiques une expérience agréable.
L’outil de scraping Web Unblocker de Floppydata vous permet de vous connecter à la plateforme, d’extraire les données requises et de les enregistrer dans un format facile à utiliser. Voici quelques-unes de ses fonctionnalités :
- Rend l’infrastructure JavaScript de la plateforme pour extraire des données complètes
- Rotation automatique des proxys intégrée pour des requêtes fiables.
- Logique de nouvelles tentatives intelligente, sans besoin de relances manuelles
Un autre facteur qui fait de Floppydata un choix de premier plan est la tarification. De plus, les coûts fréquents de maintenance des scrapers bricolés peuvent rapidement atteindre des sommes élevées qui ne sont pas pratiques pour les petites entreprises.
D’autre part, Floppydata garantit l’accessibilité en s’assurant que même les personnes qui ont besoin de scraper des données Twitter peuvent se le permettre. En outre, Floppydata offre 5 scraps gratuits aux nouveaux utilisateurs, ce qui constitue un excellent point de départ pour votre projet d’extraction de données. Vous pouvez obtenir l’outil à partir de 0,98 $ pour 1 000 résultats. Si vous avez des besoins spécifiques, vous pouvez contacter l’équipe pour obtenir un devis personnalisé.
Comment récupérer des données de Twitter avec Floppydata Web Unblocker
Extraire des données de Twitter avec le Web Unblocker de Floppydata est simple et ne prend que quelques étapes. Voici un guide simple pour extraire des données de Twitter :
Étape 1 : Visitez la page Web Unblocker et connectez-vous pour commencer.
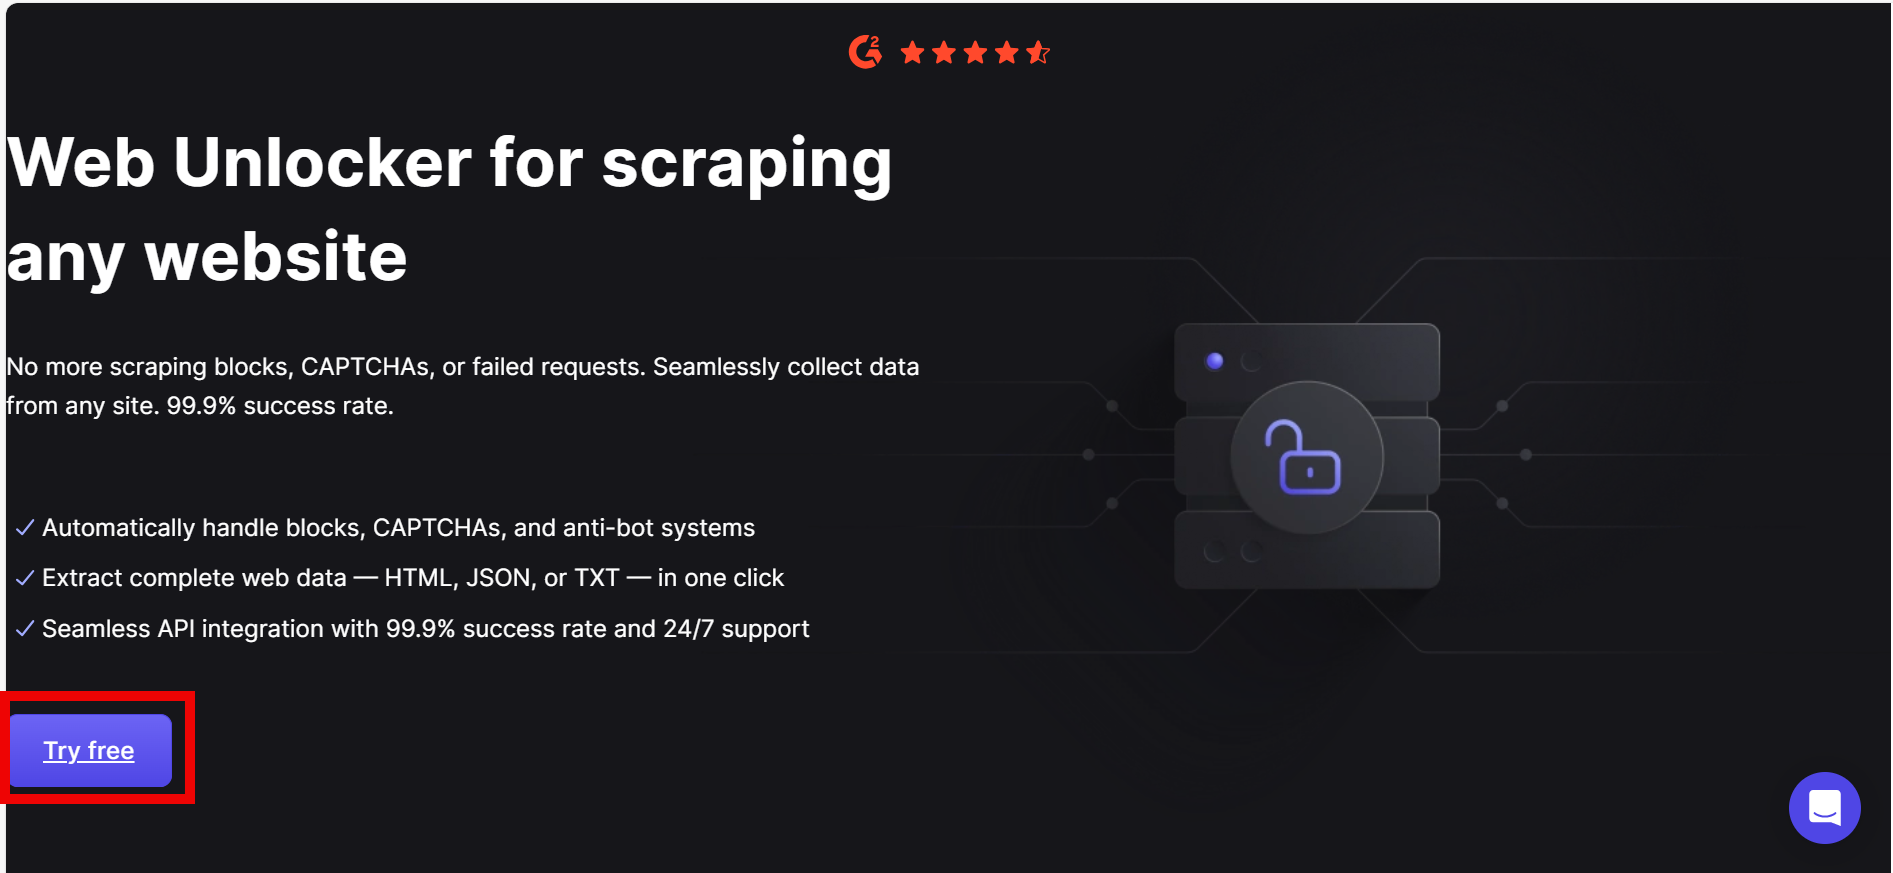
Étape 2 : Copiez l’adresse de la page publique dont vous avez besoin, par exemple le profil de votre marque ou une publication publique.
Étape 3 : Allez sur le tableau de bord de Floppydata’s Web Unblocker et collez l’URL
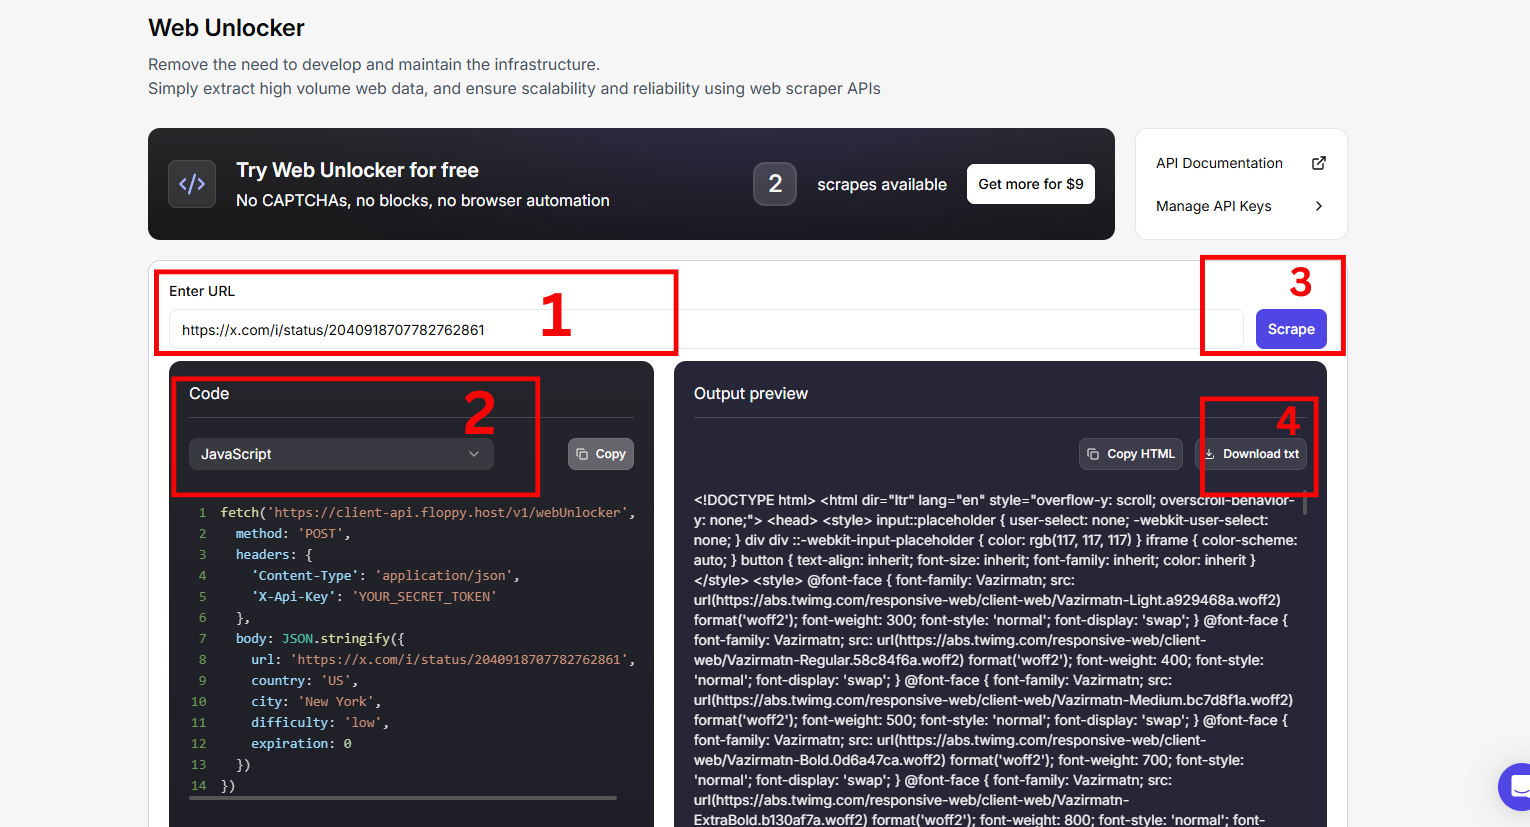
Étape 4 : Vos résultats sont prêts en quelques minutes.
Et vous avez réussi à extraire des données de Twitter sans aucun stress.
Conclusion
Apprendre à récupérer les données de Twitter est assez simple. Cependant, comme indiqué dans ce guide, X limite l’accès automatisé et modifie souvent son site ; un scraper maison demande donc une maintenance constante.
Floppydata vous décharge de cette maintenance : il affiche les pages dans un vrai navigateur, effectue la rotation des IP et relance les requêtes échouées, pour que vous puissiez vous concentrer sur les publications publiques concernant votre marque et votre marché.