Содержание
На eBay лежит золотая жила публичных данных о ценах. Миллионы актуальных объявлений — коллекционные предметы, электроника, снятые с производства детали и многое другое — всё это полезно для отслеживания цен, исследования рынка или конкурентного анализа. Проблема в том, как получать эти данные стабильно. Простой скрипт на Python быстро ломается: eBay отображает страницы с помощью JavaScript, меняет разметку и ограничивает автоматизированный трафик.
В этом гайде я покажу, как правильно парсить eBay с помощью Floppydata Web Unlocker и получать реальные результаты.
TL;DRКак парсить публичные объявления eBay, не тратя время на сломанные селекторы
• eBay ограничивает автоматизированный трафик с помощью CAPTCHA и лимитов запросов, поэтому держите частоту запросов низкой и обращайтесь только к публичным страницам.
• Более простой путь — Web Unlocker от Floppydata: он рендерит страницу, повторяет неудачные запросы и возвращает вам чистый HTML.
• Дальше достаточно Python и BeautifulSoup, чтобы вытаскивать данные объявлений для price tracking, ресёрча и аналитики.
• Многие старые туториалы по eBay scraping уже не работают — eBay перешёл с li.s-item на li.s-card, а селекторы в гайдах никто не обновил.
• Новые аккаунты Floppydata получают пять бесплатных scrape-запросов, поэтому этот гайд можно пройти без стартовых затрат.
Что такое eBay scraping?
Всё довольно просто: вы собираете публичные данные с eBay-страниц и превращаете их в удобный формат — CSV, JSON или что-то ещё. Вместо того чтобы открывать объявления вручную одно за другим, скрапер забирает данные массово.
Перед тем как перейти к коду, важно понимать два типа страниц:
- Страницы поисковой выдачи — общий список товаров с названием, ценой, состоянием, доставкой и ссылкой на объявление.
- Страницы товаров, URL вида
/itm/ITEM_ID, где находится всё самое подробное: полные описания, характеристики товара и варианты.
В этом туториале мы сфокусируемся на страницах поисковой выдачи, потому что именно с них большинство и начинает.
Зачем парсить данные eBay?
Когда сбор данных уже настроен, вариантов использования очень много. Вот основные сценарии, которые я реально использую:
- Отслеживание цен. Вы можете быстро увидеть, за сколько товары реально продаются среди тысяч активных и sold listings. И sold listings особенно важны, потому что они показывают не желаемую цену продавца, а сумму, которую покупатель действительно заплатил.
- Анализ конкурентов. Можно понять, что именно продаётся, в каком состоянии, кто это продаёт и по какой цене. Вместо догадок по ценообразованию вы работаете с реальными данными.
- Ресейл и арбитраж. Это уже практическая часть, которая может приносить деньги. Недооценённые объявления появляются постоянно, а данные помогают находить их раньше других.
- Product research. Перед тем как закупать товар или заходить в новую категорию, можно быстро проверить спрос и понять, есть ли смысл вкладывать деньги.
- Мониторинг продавцов. Если нужно следить за конкретным продавцом, логика та же: вместо поискового URL используете URL его магазина и получаете каталог, цены и изменения по ассортименту.
Если ваша работа связана с resale, ecommerce или pricing, такие данные экономят огромное количество времени и помогают принимать решения быстрее.
Когда использовать официальный API
Это хороший вариант, и его стоит проверить в первую очередь. Browse API хорошо справляется с запросами умеренного объёма по активным объявлениям в рамках правил и лимитов eBay.
Некоторые данные там представлены не так, как на самой странице. Для них парсите только публичные страницы, неторопливо, и сначала ознакомьтесь с пользовательским соглашением eBay.
Если вы только разбираетесь в теме, у Floppydata есть хороший материал о том, что такое web unlocker и как он работает.
Почему eBay сложно парсить?
Это не невозможно, но есть несколько вещей, которые быстро создают проблемы. Чаще всего люди упираются в два момента.
Первое — ограничения на автоматизированный трафик. eBay использует CAPTCHA и лимиты запросов, и при слишком большом числе запросов ошибки 403 появляются очень быстро. В начале 2026 защита стала жёстче, поэтому важно работать аккуратно: только публичные данные, нормальная частота запросов и никаких действий, связанных с заказами или приватной информацией.
Второй момент — разметка страницы. И это более скрытая проблема. Когда я готовил этот гайд, заметил, что eBay уже перешёл с li.s-item на li.s-card, а внутри теперь используются .s-card__title, .s-card__price, .s-card__subtitle и похожие элементы. Многие гайды в интернете всё ещё ссылаются на старую структуру, поэтому они просто не работают. Селекторы рано или поздно устаревают, это нормально для eBay, поэтому лучше сразу добавлять defensive checks для отсутствующих полей.
Именно поэтому я пропускаю весь трафик через Web Unlocker от Floppydata: он рендерит страницу и повторяет запросы за меня.
Что понадобится
Три вещи:
- Python 3.10 или выше
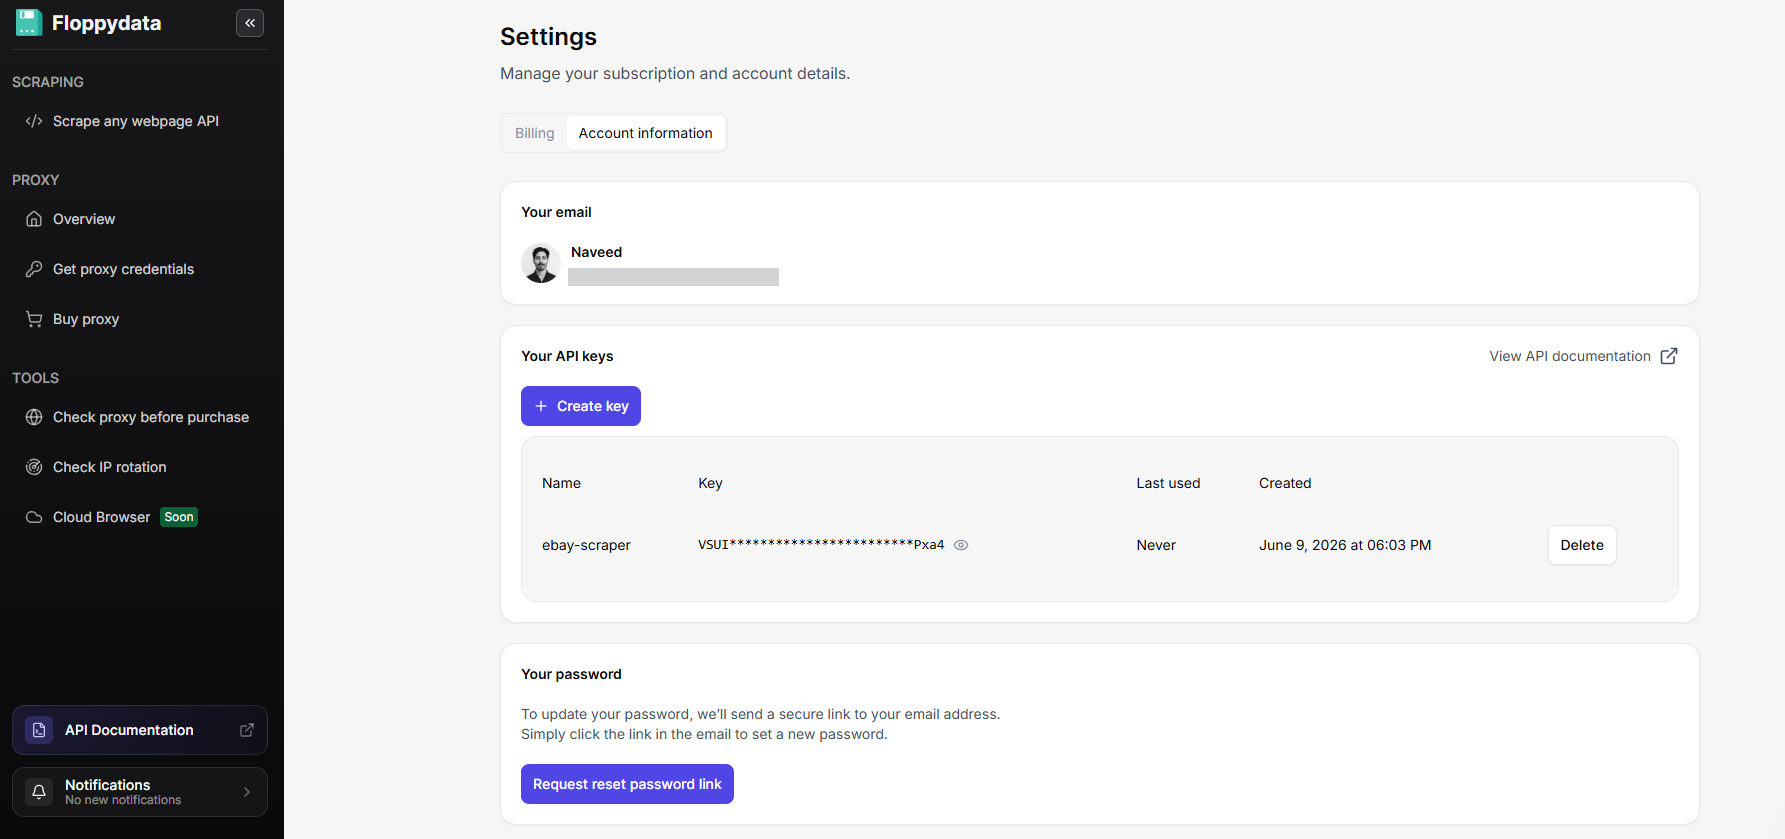
- Аккаунт Floppydata с API-ключом для Web Unlocker. Новые аккаунты получают пять бесплатных scrape-запросов, поэтому пройти этот гайд можно без оплаты. Ключ находится в dashboard Web Unlocker.
- Две библиотеки:
requestsиbeautifulsoup4
Сначала установите библиотеки:
pip install requests beautifulsoup4
Затем создайте папку проекта:
mkdir ebay-scraper
cd ebay-scraper
touch ebay_scraper.py
Scraping eBay через Floppydata Web Unlocker
Он берёт на себя всё неприятное: резидентский IP, рендеринг страниц, повторные попытки — и возвращает вам чистый HTML. Плюс списание идёт только за успешные scrape-запросы, поэтому вы не теряете кредиты на неудачных попытках.
Перед кодом я всегда тестирую URL в playground внутри dashboard (no-code Web Unlocker playground). Вставляете search URL, нажимаете Scrape и смотрите, что вернулось. Так намного проще писать parser, когда уже понятно, с каким HTML вы работаете.
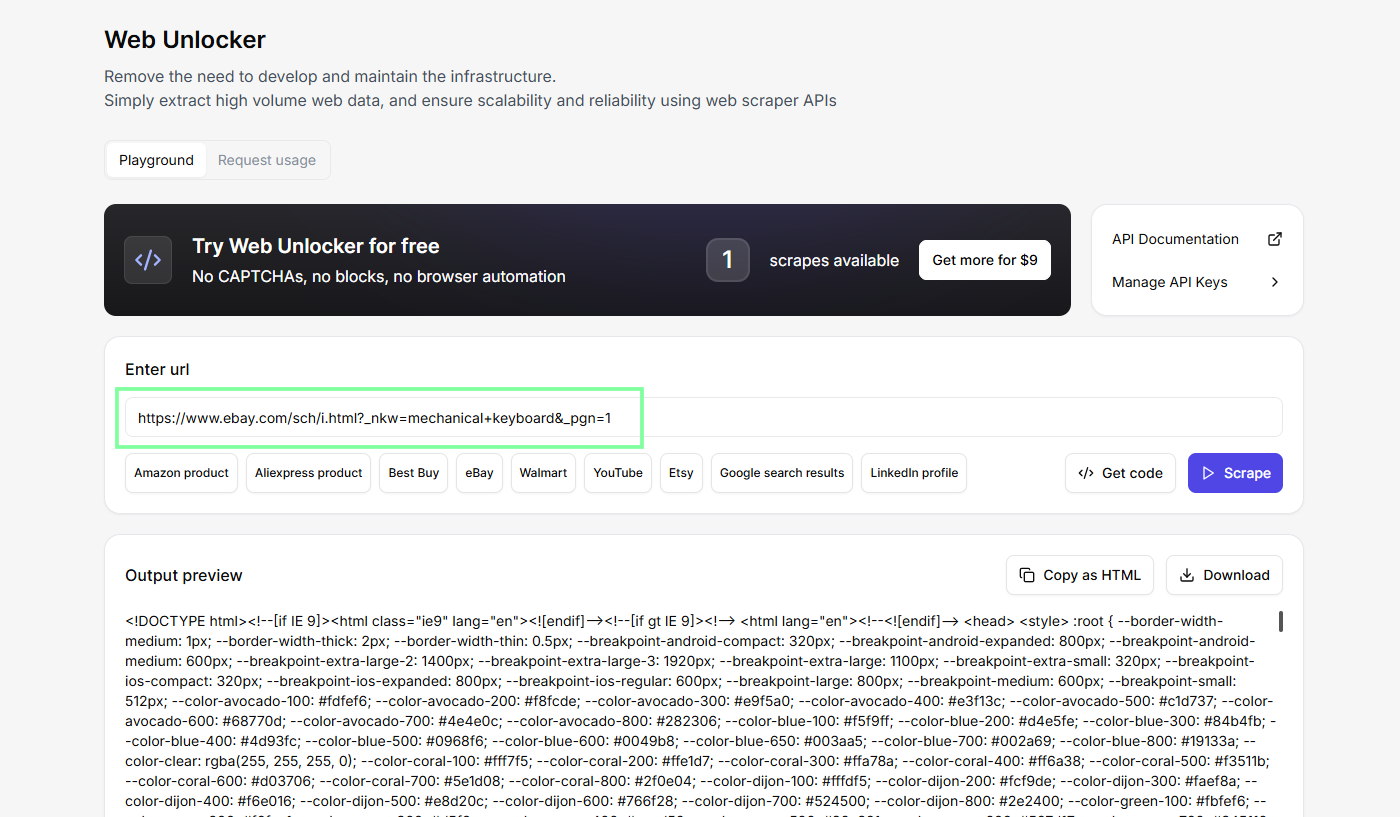
HTML у нас есть, теперь переходим к коду.
Step 1: настраиваем запрос
import requests
import json
from bs4 import BeautifulSoup

API_URL = "https://api.floppydata.net/v1/webUnlocker"
API_KEY = "YOUR_API_KEY"

SEARCH_URL = "https://www.ebay.com/sch/i.html?_nkw=mechanical+keyboard&_pgn=1"
OUTPUT_FILE = "ebay_listings.json"
Замените YOUR_API_KEY на ключ из dashboard.
Параметр _pgn=1 — это номер страницы. Если нужна вторая страница, меняете на _pgn=2. Третья — _pgn=3. Всё просто.
Step 2: получаем страницу через Web Unlocker
def fetch_html(url):
    response = requests.post(
        API_URL,
        headers={
            "Content-Type": "application/json",
            "X-Api-Key": API_KEY,
        },
        json={
            "url": url,
            "country": "US",
            "city": "New York",
            "difficulty": "medium",
            "expiration": 0,
        },
        timeout=120,
    )

    response.raise_for_status()

    data = response.json()
    html = data.get("html")

    if not html:
        raise ValueError("Unlocker response did not include an 'html' field.")

    return html
Country и city направляют запрос через US residential IP. Сложность medium — оптимальная настройка для eBay, потому что его страницы требуют полного рендеринга. Если поставить ниже, можно просто получить блок. Expiration 0 заставляет каждый раз брать свежую страницу, а не cached response. Готовый HTML возвращается в поле html внутри JSON — именно его дальше парсит BeautifulSoup.
Step 3: извлекаем объявления
Каждый результат на странице выдачи находится внутри контейнера li.s-card. Чтобы аккуратно спарсить eBay listings, мы проходим по каждой карточке и вытаскиваем нужные поля. Defensive checks нужны, чтобы скрипт не падал, если какое-то поле отсутствует:
def extract_listings(html):
    soup = BeautifulSoup(html, "html.parser")
    cards = soup.select("li.s-card")
    listings = []

    for card in cards:
        title_el = card.select_one(".s-card__title")
        title = title_el.get_text(" ", strip=True) if title_el else None

        if title:
            # eBay appends this as accessibility text
            title = title.replace("Opens in a new window or tab", "").strip()

        # Skip the placeholder card at the top of search results
        if not title or title == "Shop on eBay":
            continue

        price_el = card.select_one(".s-card__price")
        condition_el = card.select_one(".s-card__subtitle")

        # Shipping info sits inside attribute rows
        shipping = None

        for row in card.select(".s-card__attribute-row"):
            text = row.get_text(" ", strip=True)

            if any(word in text.lower() for word in ("ship", "free", "delivery")):
                shipping = text
                break

        # Grab the first link that points to an item detail page
        url = None

        for a in card.select("a.s-card__link"):
            href = a.get("href")

            if href and "/itm/" in href:
                url = href.split("?")[0]
                break

        listings.append({
            "title": title,
            "price": price_el.get_text(" ", strip=True) if price_el else None,
            "condition": condition_el.get_text(" ", strip=True) if condition_el else None,
            "shipping": shipping,
            "url": url,
        })

    return listings
Есть два важных нюанса:
- eBay всегда добавляет placeholder card “Shop on eBay” вверху выдачи. Если её не пропустить, первый элемент в массиве listings будет мусором.
- В title также может попадать “Opens in a new window or tab” как accessibility text из anchor tag. Строка с replace очищает это до добавления результата.
Step 4: сохраняем результаты
def main():
    print(f"Fetching data from: {SEARCH_URL}")

    html = fetch_html(SEARCH_URL)
    listings = extract_listings(html)

    if not listings:
        raise SystemExit("No listings found. eBay may have changed its markup.")

    with open(OUTPUT_FILE, "w", encoding="utf-8") as file:
        json.dump(listings, file, indent=2)

    print(f"Found {len(listings)} listings")
    print(f"Saved results to {OUTPUT_FILE}")


if __name__ == "__main__":
    main()
Запустите скрипт:
python ebay_scraper.py
И вы должны увидеть примерно такой результат:
[
  {
    "title": "MSI Forge GK600 TKL Wireless Mechanical Keyboard RGB Bluetooth 2.4GHz",
    "price": "$49.99",
    "condition": "Brand New",
    "shipping": "Free shipping",
    "url": "https://www.ebay.com/itm/227344950627"
  }
]
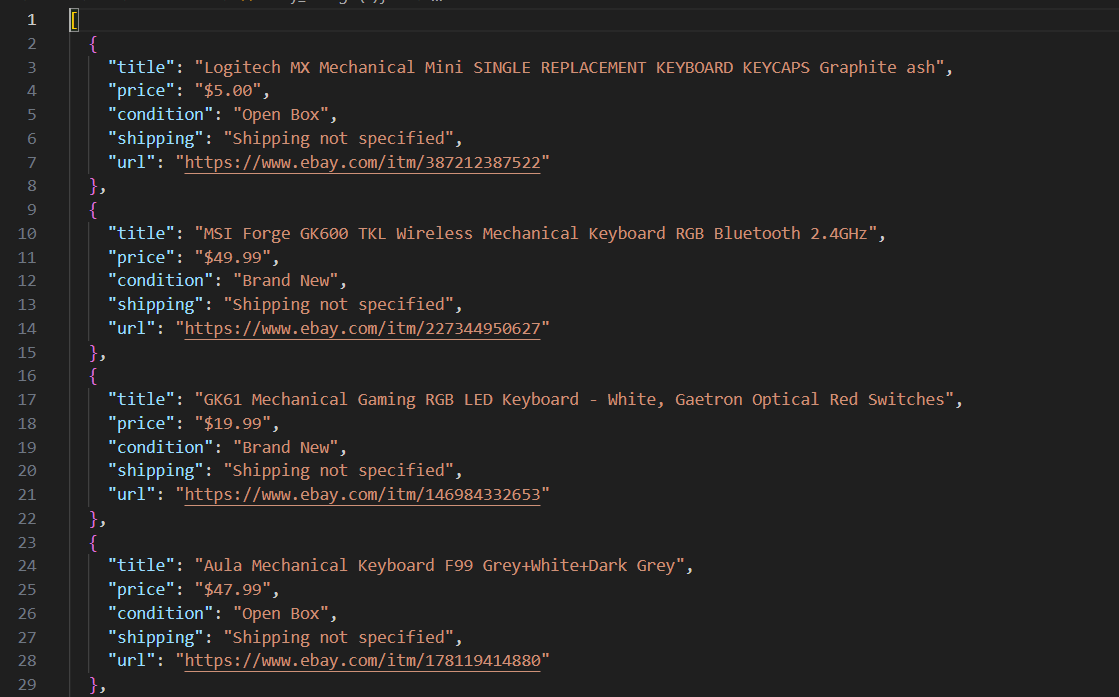
Это значит, что базовый скрапер работает.
Дальше сменить keyword очень просто: меняете _nkw=mechanical+keyboard в URL. Если нужна другая страница, переходите с _pgn=1 на _pgn=2, _pgn=3 и так далее.
Troubleshooting
Если парсить eBay достаточно долго, вы почти наверняка столкнётесь с одним из этих сценариев:
- Ошибки 403: eBay ограничивает ваши запросы. Снизьте скорость и повторите попытку позже; не пытайтесь обойти блокировку.
- Empty responses: чаще всего это проблема с rendering. Проверьте, что вы читаете именно поле
htmlв ответе Web Unlocker, а не raw JSON body. - Missing fields: не у каждого объявления есть condition или shipping. Defensive checks в
extract_listingsуже это учитывают. - No results at all: eBay снова поменял CSS-классы. Вернитесь в playground, посмотрите новую разметку и обновите selectors.
Следующий шаг
Честно говоря, eBay — не самый сложный сайт, но из-за лимитов на запросы и того, что разметка иногда внезапно меняется, работа без правильной настройки просто съест ваше время. Если пускать трафик через инструмент, который берёт на себя рендеринг и повторные попытки, можно сразу переходить к работе с данными.
Именно в этом силён Web Unlocker от Floppydata. Ротация резидентских прокси, полный рендеринг страниц, а платите вы только за успешные ответы, так что неудачный парсинг ничего вам не стоит. Добавьте пару строк BeautifulSoup — и всё становится довольно просто, честно говоря.
Новые аккаунты получают пять бесплатных scrape-запросов, поэтому этот гайд можно пройти без оплаты.